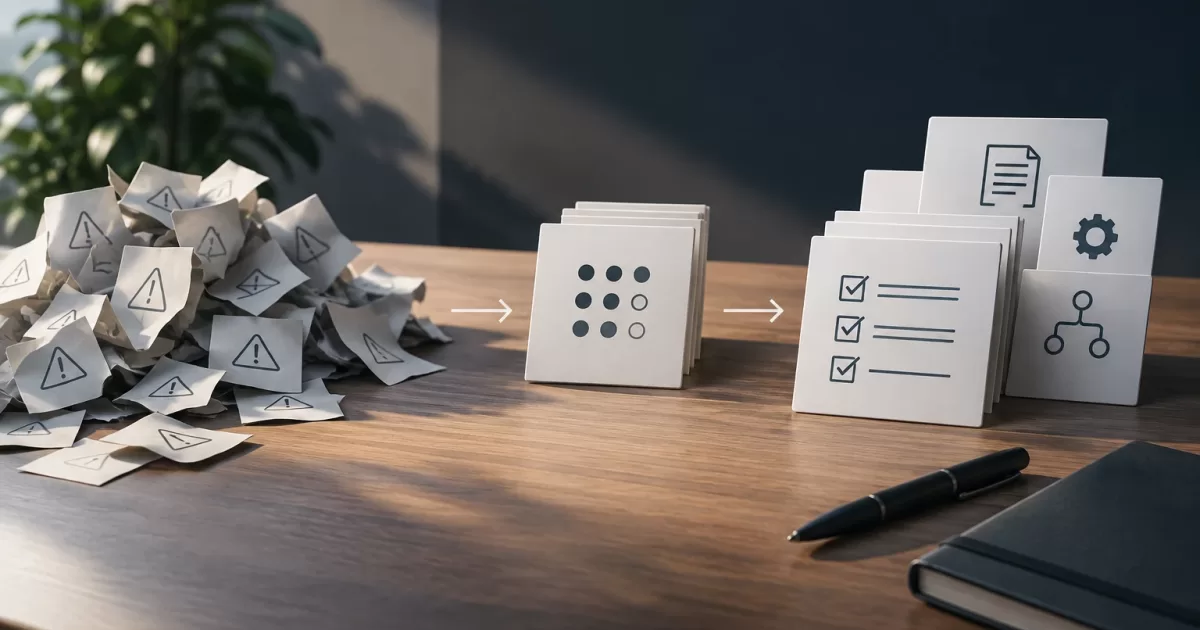
Lorsque le support reçoit plusieurs demandes similaires, la réaction habituelle consiste à demander une modification. Pourtant, la répétition ne prouve pas à elle seule qu’il existe une nouvelle exigence : elle peut signaler un défaut, une interface confuse, un manque de formation ou une exception mal gérée. Modifier une application PHP avant d’en comprendre la cause peut automatiser le problème ou introduire une règle qui ne correspond pas au travail réel.
Transformer des incidents récurrents en exigences logicielles consiste à passer de récits individuels à une décision vérifiable : qui a besoin de quel résultat, dans quelles conditions et avec quelles exceptions. Ce processus aide les équipes produit, opérations et développement à s’accorder sur le périmètre avant d’estimer et de modifier le code.
Pourquoi un incident répété n’équivaut pas automatiquement à une exigence
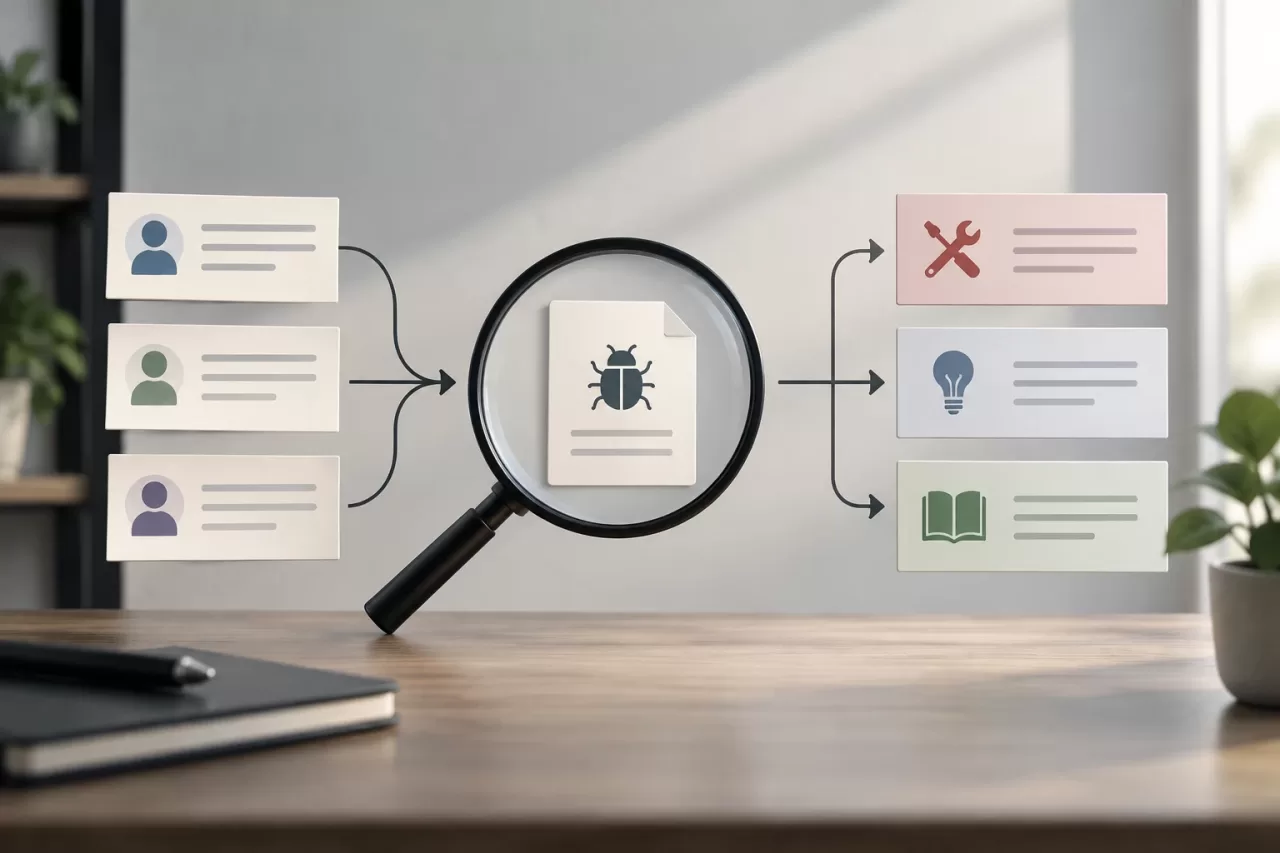
Un incident décrit ce qui s’est produit ; une exigence exprime une capacité ou une contrainte que le système doit respecter. Par exemple, plusieurs utilisateurs qui demandent de l’aide pour corriger une facture rencontrent peut-être le même défaut de calcul. Ils peuvent aussi ne pas connaître une fonctionnalité existante ou suivre une procédure qui n’est pas documentée.
Compter les demandes sans les classer peut fausser les priorités. Un même utilisateur peut ouvrir plusieurs tickets pour un seul problème, tandis qu’un risque important peut n’apparaître qu’une fois. Il est préférable de regrouper les demandes selon leur cause et le résultat affecté, et non uniquement selon des formulations similaires ou le nombre de tickets.
Classer : défaut, formation, exception ou nouveau besoin
Avant de proposer une amélioration, déterminez quel type de situation est observé :
- Défaut : le système ne respecte pas une règle déjà convenue. Comparez le comportement réel avec la spécification, les journaux et les cas reproductibles.
- Manque de formation ou de clarté : la fonctionnalité existe, mais les utilisateurs ne la trouvent pas ou interprètent différemment le parcours. Examinez les instructions, les libellés et les étapes.
- Exception : un cas légitime ne s’inscrit pas dans le flux habituel, comme un remboursement partiel ou une approbation en dehors des heures de travail. Déterminez s’il s’agit d’une exception valide et qui peut l’autoriser.
- Nouveau besoin : le processus a changé ou une capacité qui ne faisait pas partie du comportement attendu est manquante. Il faut en évaluer la valeur, le périmètre et les conséquences.
La classification peut évoluer au cours de l’analyse. Ne tranchez pas uniquement à partir du titre du ticket : demandez ce que la personne cherchait à accomplir et quel résultat elle attendait.
Recueillir le contexte et les éléments permettant de comprendre le cas
Un rapport utile reconstitue le parcours, et pas seulement le dernier message d’erreur. Consignez le rôle de la personne qui effectue la tâche, son objectif, les étapes précédentes, les données pertinentes, le résultat obtenu et le résultat attendu. Ajoutez la fréquence, l’impact opérationnel et les éléments disponibles, comme une capture d’écran, un identifiant d’opération ou un journal technique.
Dans les applications PHP, l’équipe peut mettre en corrélation le récit avec les journaux, les réponses de l’API, les validations côté serveur et les données persistées, en respectant les autorisations et les contrôles de confidentialité appropriés. Évitez de copier des informations personnelles ou des identifiants dans les tickets ; utilisez des données anonymisées ou des références sécurisées. Les éléments recueillis aident à reproduire le cas, mais ne remplacent pas l’explication de la règle métier.
Questions pratiques à poser au support ou à l’équipe produit :
- Qui effectue la tâche et avec quelles autorisations ?
- Qu’essayait-il d’accomplir et pourquoi ?
- Quelles étapes et conditions ont précédé le problème ?
- Qu’attendait-il et que s’est-il réellement passé ?
- Existe-t-il des exemples qui ont fonctionné et d’autres qui ont échoué ?
- Quel est l’impact et existe-t-il une solution manuelle acceptable ?
Identifier la règle métier et consigner ses exceptions
Plusieurs exemples permettent de formuler une hypothèse, mais ne suffisent pas à établir une règle. Confrontez les cas aux personnes qui exécutent le processus et à celles qui sont responsables de ses politiques. Cherchez quelle condition modifie le résultat : état de l’opération, type de client, montant, délai, autorisations ou relation entre les enregistrements.
Énoncez la règle clairement et indiquez ses limites. Par exemple : « Une demande peut être approuvée si elle est complète et concerne une période ouverte. » Précisez ensuite ce que signifie « complète », qui détermine si la période est ouverte et ce qui se passe pour les demandes corrigées, en double ou reçues à la clôture. Si les personnes responsables ne s’accordent pas sur ces réponses, la spécification n’est pas encore stable.
Les exceptions ne sont pas des détails à dissimuler dans une note. Elles peuvent nécessiter des autorisations différentes, une vérification humaine, l’enregistrement d’un motif ou un flux distinct. Si une exception est rare mais a un impact élevé, sa faible fréquence ne la rend pas négligeable.
Rédiger des critères d’acceptation observables
Une exigence peut être validée lorsqu’elle décrit des résultats que quelqu’un peut vérifier. Évitez les formulations comme « gérer correctement » ou « simplifier » si elles ne sont pas accompagnées de conditions concrètes. Les critères doivent couvrir le flux normal, les données invalides, les autorisations et les cas limites identifiés.
Une façon simple de les rédiger est : « Étant donné [contexte], lorsque [action], alors [résultat observable]. » Par exemple : « Étant donné un utilisateur autorisé et une période ouverte, lorsque celui-ci soumet une demande complète, le système l’enregistre avec le statut “en attente” et affiche son identifiant. » Ajoutez un autre critère pour une période clôturée et précisez si la demande est rejetée, conservée comme brouillon ou soumise à approbation.
Pour une application PHP, les critères peuvent guider les tests unitaires des règles métier, les tests d’intégration de la persistance ou de l’API, ainsi que les tests fonctionnels du parcours. Ne prescrivez pas une implémentation avant d’avoir compris le besoin : une règle peut relever de la validation, de l’autorisation, d’une transition d’état ou d’une modification du processus.
Établir les priorités et valider avec les équipes produit, opérations et développement
Établissez les priorités en fonction de l’impact, du risque, du périmètre et du coût d’opportunité, et pas uniquement du volume de tickets. Déterminez combien de personnes ou de processus sont concernés, quelles sont les conséquences du problème, s’il existe une mesure de contrôle temporaire et quel travail est nécessaire pour prendre également en charge les exceptions. Un problème peu fréquent peut mériter une attention prioritaire s’il entraîne une perte de données ou le non-respect d’une obligation.
Avant l’estimation, l’équipe produit doit confirmer le résultat et les limites ; les opérations, que le flux décrit la pratique réelle ; et le développement, que les critères sont compréhensibles sur le plan technique et vérifiables. Si des doutes subsistent, convenez d’une investigation limitée, d’un test manuel ou de l’observation du processus. Ne transformez pas une hypothèse en automatisation simplement pour clôturer les tickets plus rapidement.
Après la modification, validez les critères avec des cas représentatifs et vérifiez si la cause initiale diminue sans créer de nouveaux blocages. L’implémentation, le déploiement et l’activation pour les utilisateurs sont des décisions distinctes : si le risque le justifie, une release peut être activée progressivement, avec des métriques et une option de rollback. Documentez ce qui constitue une réussite et qui décide d’interrompre ou d’ajuster la livraison.
Modèle court pour transformer un incident en décision
Utilisez cette fiche comme point de départ et ne renseignez que les éléments que vous pouvez étayer par des preuves :
- Groupe d’incidents et période : tickets associés, dates et critère utilisé pour les regrouper.
- Personne et tâche : rôle, objectif et contexte opérationnel.
- Comportement observé : étapes, données pertinentes et résultat réel.
- Résultat attendu : besoin exprimé sans proposer encore de solution.
- Classification et hypothèse : défaut, formation, exception ou nouveau besoin ; cause à confirmer.
- Règle et exceptions : condition qui détermine le résultat, responsable de la règle et limites connues.
- Impact et solution de remplacement : conséquences, périmètre et procédure temporaire.
- Critères d’acceptation : cas normaux et invalides, autorisations et limites, avec des résultats observables.
- Décision et validation : priorité, responsables, tests prévus et indicateur de réexamen du résultat.
S’il est impossible de préciser la règle, les exceptions ou les résultats attendus, la bonne conclusion peut être d’enquêter, d’améliorer la formation ou de corriger le défaut existant, plutôt que de créer une nouvelle fonctionnalité. Cette distinction transforme les demandes récurrentes adressées au support en décisions produit plus claires et réduit les modifications fondées sur des suppositions.