Uma importação que leva horas, um relatório que consulta várias fontes ou uma tarefa que coordena integrações pode continuar consumindo recursos muito depois de deixar de ser útil. Sem limites explícitos, também é difícil saber se está trabalhando, bloqueada ou incompleta. Projetar limites de tempo em processos PHP de longa duração exige definir quanto tempo cada etapa pode levar, como o trabalho é interrompido e qual estado é preservado se a execução for interrompida.
O objetivo não é impor um único número a todo o processo. É estabelecer um orçamento coerente de ponta a ponta, transmiti-lo às operações dependentes e fazer com que o estado final reflita o que aconteceu. Um timeout, um cancelamento solicitado e um encerramento forçado são situações distintas e devem ser tratados como tal.
Por que é necessário um limite explícito
Um processo sem prazo pode reter memória, conexões e capacidade de execução indefinidamente. Também pode deixar uma tarefa marcada como ativa mesmo que ela já não esteja progredindo. Em um ambiente com workers, o problema se amplia: uma execução bloqueada ocupa um worker e pode atrasar trabalhos posteriores.
Os limites do PHP ou do servidor não substituem uma política da aplicação. Por exemplo, max_execution_time pode limitar a execução de um script, mas não necessariamente representa o tempo total que o negócio aceita esperar. Além disso, os limites do servidor web, PHP-FPM, gerenciador de filas, cliente HTTP e banco de dados podem atuar de forma independente. Se forem diferentes, uma camada pode encerrar o trabalho sem que outra consiga salvar o estado correspondente.
Identifique primeiro onde o processo é executado e quais componentes podem interrompê-lo. Uma tarefa de console, um worker de fila e uma requisição web têm mecanismos e consequências distintos. O limite da aplicação deve coexistir com esses controles externos, e não depender de que um deles resolva sozinho o encerramento.
Diferencie timeout, deadline e cancelamento
- Timeout de uma operação: tempo máximo que uma chamada específica pode esperar, como uma consulta ou uma requisição HTTP.
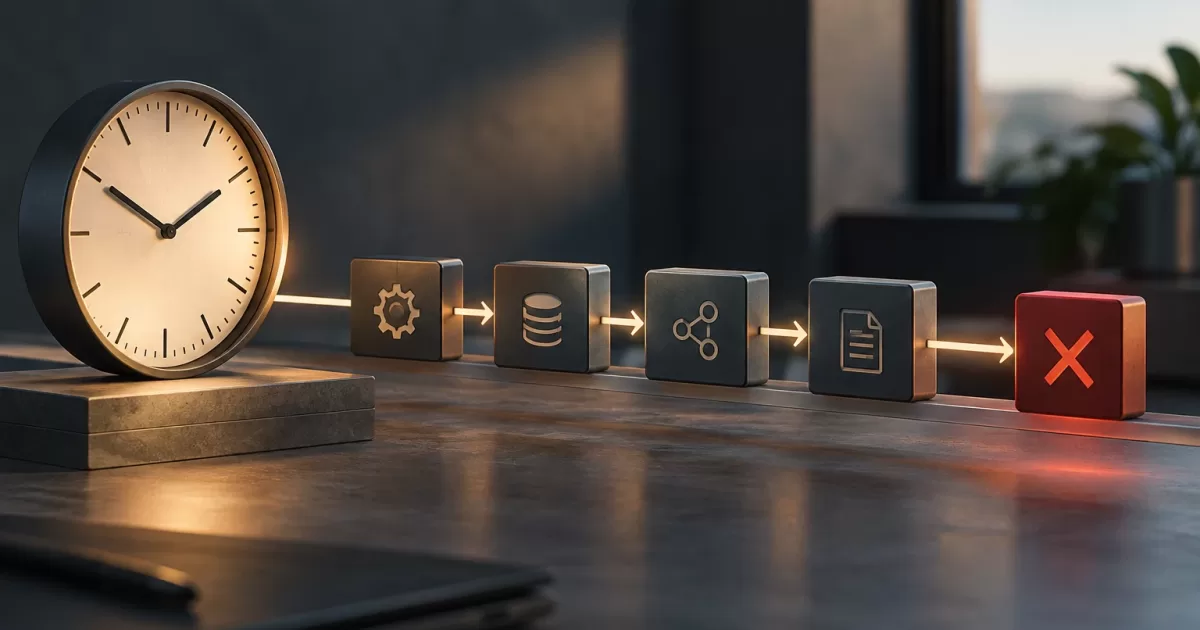
- Deadline global: instante-limite para o processo inteiro. As etapas compartilham o tempo restante, em vez de cada uma receber o prazo total.
- Cancelamento solicitado: decisão explícita de parar o trabalho, por exemplo porque um usuário cancelou a tarefa ou o sistema a removeu de uma fila.
Um timeout informa que uma operação não terminou dentro do seu orçamento. Por si só, não implica que o processo inteiro deva ser interrompido: isso depende da etapa e das regras do produto. O cancelamento, por outro lado, é um sinal de controle que o processo deve verificar e atender quando puder fazê-lo com segurança. Nenhum dos dois garante que um sistema operacional ou supervisor interrompa uma execução em um ponto preciso; um encerramento forçado pode ocorrer entre verificações.
Represente o deadline como um instante absoluto ou como o tempo restante calculado a partir de um relógio monotônico. Antes de iniciar uma etapa, verifique se ainda há tempo disponível. Isso evita que uma sequência de operações com timeouts individuais consuma muito mais do que o prazo global. Em PHP, encapsule o cálculo e a verificação de cancelamento em um objeto ou serviço compartilhado, em vez de duplicar comparações dispersas.
Distribua o orçamento entre etapas e dependências
Decomponha o processo em etapas observáveis: leitura, transformação, gravação e coordenação externa, por exemplo. Defina quanto tempo cada uma pode consumir sem ultrapassar o deadline global. Não é necessário que todos os prazos sejam idênticos: uma etapa com trabalho local limitado pode precisar de um limite diferente do de uma chamada a um serviço remoto.
Ao chamar uma dependência, use o menor valor entre o timeout operacional dela e o tempo restante do processo. Configure separadamente os limites de conexão e de leitura quando a biblioteca permitir. Uma conexão rápida não impede que a resposta demore demais, e um timeout de leitura não inclui necessariamente todo o tempo anterior. Aplique o mesmo princípio a consultas SQL, operações de armazenamento e processos secundários, usando os controles disponibilizados por cada cliente.
Se uma operação não admitir cancelamento, não a apresente como imediatamente interrompível. Você pode limitar o tempo de espera, isolá-la em uma unidade de trabalho separada ou projetar o fluxo para verificar o cancelamento antes e depois. Para subprocessos, mantenha o identificador necessário para solicitar seu encerramento e verifique se o processo terminou; enviar um sinal não equivale a confirmar sua saída.
Interrompa o trabalho e deixe um estado compreensível
Quando o deadline expirar ou chegar um cancelamento, evite iniciar novas etapas. Nos pontos seguros, conclua as ações locais indispensáveis para registrar o resultado e libere recursos controláveis, como cursores ou arquivos temporários. O bloco de limpeza não deve tentar concluir o trabalho pendente: ele também deve ter duração limitada e não ocultar a causa da interrupção.
Salve o estado da tarefa em um local durável, associado a um identificador estável. No mínimo, registre estados distintos, por exemplo running, completed, cancelled e timed_out, além da etapa atual e dos timestamps relevantes. Acrescente um motivo legível para os operadores, sem salvar dados sensíveis desnecessários. Atualize o estado atomicamente sempre que possível e considere que o processo pode morrer antes de concluir essa atualização.
O resultado apresentado a quem iniciou a tarefa deve distinguir «cancelada» de «falha por prazo excedido». Se o estado ainda não puder ser confirmado após um encerramento abrupto, mostre-o como desconhecido ou pendente de verificação, não como concluído. As métricas e os logs estruturados podem incluir duração, etapa e tipo de interrupção; evite registrar segredos, conteúdo privado ou rastreamentos sem controle de acesso.
Decida se os efeitos parciais podem ser retomados
Uma interrupção pode ocorrer depois da gravação de dados e antes do registro de que a etapa terminou. Por isso, decidir se é possível retomar não consiste apenas em salvar o número da etapa: é preciso entender quais efeitos podem ter ocorrido. Para operações locais, uma transação pode agrupar alterações relacionadas se a duração e o mecanismo permitirem. Não mantenha uma transação aberta durante uma chamada externa longa.
Para trabalhos em lote, registre as unidades concluídas com uma chave estável e defina quando uma unidade está realmente confirmada. Se uma gravação for repetida após a reinicialização, o projeto deve impedir duplicatas ou reconhecer que o efeito já existe. Uma integração externa que não oferece cancelamento pode ter aceitado uma solicitação mesmo que o cliente tenha parado de esperar; o estado deve refletir essa incerteza, em vez de presumir que não houve efeito.
Se não for seguro continuar a partir do último ponto salvo, marque a tarefa para revisão ou para uma recuperação específica. Retomar automaticamente a partir de um marcador impreciso pode produzir um resultado incorreto. Documente quais etapas podem ser repetidas, quais exigem verificação e quais condições permitem declarar o processo concluído.
Teste os limites e as interrupções
Os testes devem verificar tanto a interrupção quanto o estado final, não apenas se uma exceção foi lançada. Use dependências controláveis para simular uma chamada lenta, uma consulta que excede seu prazo e uma resposta que chega exatamente no limite. Verifique se o tempo de uma etapa não permite ignorar o deadline global.
Teste um cancelamento entre etapas e durante uma operação que só pode ser interrompida quando retornar. Simule também um encerramento abrupto em pontos relevantes: após um efeito externo, antes de salvar o estado e durante a limpeza. Após reiniciar o worker, verifique se o estado é compreensível e se a política de retomada não duplica nem omite trabalho. Esses testes devem usar dados isolados e não depender de serviços externos reais.
Lista de verificação para um processo existente
- Identifique os limites do PHP, do servidor, do worker e de cada cliente utilizado.
- Defina um deadline global e orçamentos por etapa que, somados, não o excedam.
- Propague o tempo restante para HTTP, banco de dados e outros processos sempre que possível.
- Verifique o cancelamento em pontos seguros e evite iniciar novos trabalhos após recebê-lo.
- Persista estados distintos, a etapa atual e a causa do encerramento.
- Descreva quais efeitos parciais podem permanecer e quais condições permitem retomar.
- Teste atrasos, cancelamentos, encerramentos abruptos e o estado observado após a reinicialização.
Um projeto sólido não promete que toda operação possa ser interrompida instantaneamente. Ele explicita o tempo disponível, limita a espera em cada dependência e preserva informações suficientes para interpretar uma interrupção. Essa combinação permite que um processo longo deixe de ser uma execução opaca e se torne uma unidade operável e verificável.