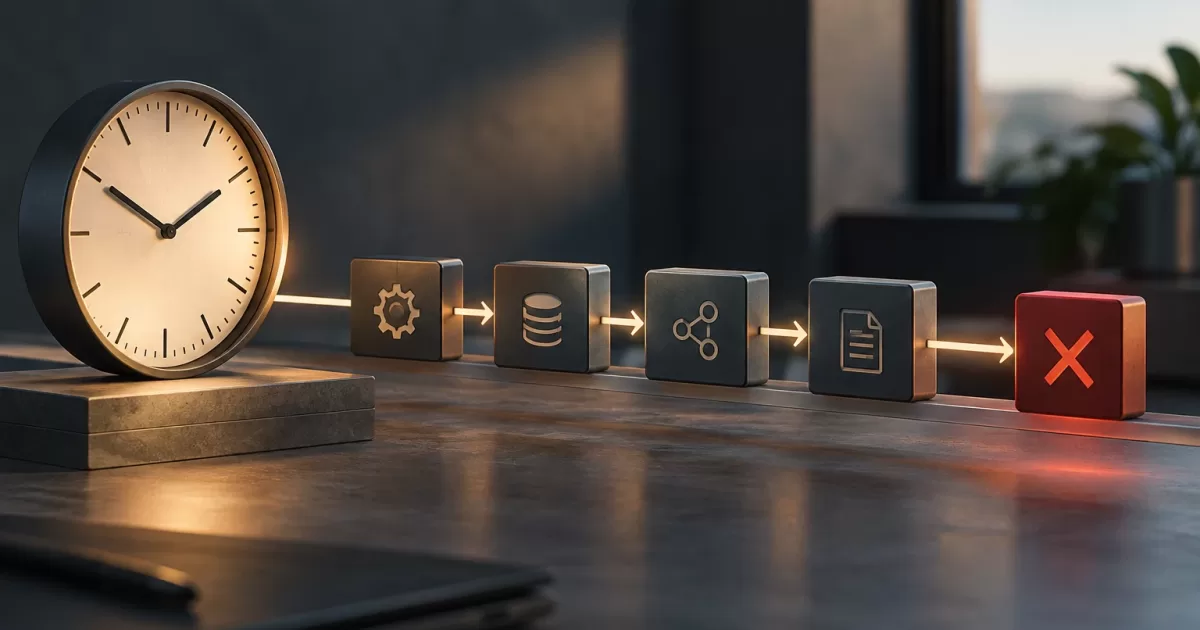
Una importación que tarda horas, un informe que consulta varias fuentes o una tarea que coordina integraciones puede seguir consumiendo recursos mucho después de que haya dejado de ser útil. Sin límites explícitos, también resulta difícil saber si está trabajando, bloqueada o incompleta. Diseñar límites de tiempo en procesos PHP de larga duración exige definir cuánto puede durar cada etapa, cómo se detiene el trabajo y qué estado se conserva si la ejecución se interrumpe.
El objetivo no es imponer un único número a todo el proceso. Es establecer un presupuesto coherente de principio a fin, transmitirlo a las operaciones dependientes y hacer que el estado final refleje lo ocurrido. Un timeout, una cancelación solicitada y una terminación forzada son situaciones distintas y deben tratarse como tales.
Por qué hace falta un límite explícito
Un proceso sin plazo puede retener memoria, conexiones y capacidad de ejecución indefinidamente. También puede dejar una tarea marcada como activa aunque ya no progrese. En un entorno con workers, el problema se amplifica: una ejecución bloqueada ocupa un worker y puede retrasar trabajos posteriores.
Los límites de PHP o del servidor no sustituyen una política de aplicación. Por ejemplo, max_execution_time puede limitar la ejecución de un script, pero no necesariamente representa el tiempo total que el negocio acepta esperar. Además, los límites del servidor web, PHP-FPM, el gestor de colas, el cliente HTTP y la base de datos pueden actuar de forma independiente. Si difieren, una capa puede finalizar el trabajo sin que otra llegue a guardar el estado correspondiente.
Identifica primero dónde se ejecuta el proceso y qué componentes pueden detenerlo. Una tarea de consola, un worker de cola y una petición web tienen mecanismos y consecuencias distintas. El límite de aplicación debe convivir con esos controles externos, no depender de que uno de ellos resuelva por sí solo la terminación.
Distingue timeout, deadline y cancelación
- Timeout de una operación: máximo que una llamada concreta puede esperar, como una consulta o una solicitud HTTP.
- Deadline global: instante límite para el proceso completo. Las etapas comparten el tiempo restante, en vez de recibir cada una el plazo total.
- Cancelación solicitada: decisión explícita de dejar de trabajar, por ejemplo porque un usuario canceló la tarea o el sistema la retiró de una cola.
Un timeout informa de que una operación no terminó dentro de su presupuesto. No implica por sí solo que el proceso entero deba detenerse: eso depende de la etapa y de las reglas del producto. La cancelación, en cambio, es una señal de control que el proceso debe comprobar y atender cuando pueda hacerlo de forma segura. Ninguna de las dos garantiza que un sistema operativo o un supervisor detenga una ejecución en un punto preciso; una terminación forzada puede ocurrir entre comprobaciones.
Representa el deadline como un instante absoluto o como tiempo restante calculado a partir de un reloj monotónico. Antes de iniciar una etapa, comprueba si aún hay margen. Esto evita que una secuencia de operaciones con timeouts individuales consuma mucho más que el plazo global. En PHP, encapsula el cálculo y la consulta de cancelación en un objeto o servicio compartido, en lugar de duplicar comparaciones dispersas.
Reparte el presupuesto entre etapas y dependencias
Descompón el proceso en etapas observables: lectura, transformación, escritura y coordinación externa, por ejemplo. Define cuánto tiempo puede consumir cada una sin superar el deadline global. No hace falta que todos los plazos sean idénticos: una etapa con trabajo local acotado puede necesitar un límite distinto de una llamada a un servicio remoto.
Al invocar una dependencia, usa el menor valor entre su timeout operativo y el tiempo restante del proceso. Configura por separado los límites de conexión y de lectura cuando la biblioteca lo permita. Una conexión rápida no impide que la respuesta tarde demasiado, y un timeout de lectura no incluye necesariamente todo el tiempo previo. Aplica el mismo principio a consultas SQL, operaciones de almacenamiento y procesos secundarios, usando los controles que ofrezca cada cliente.
Si una operación no admite cancelación, no la presentes como interrumpible de inmediato. Puedes limitar cuánto esperas, aislarla en una unidad de trabajo separada o diseñar el flujo para comprobar la cancelación antes y después. Para subprocesos, conserva el identificador necesario para solicitar su terminación y verifica que el proceso haya finalizado; enviar una señal no equivale a confirmar su salida.
Detén el trabajo y deja un estado entendible
Cuando el deadline vence o llega una cancelación, evita iniciar nuevas etapas. En los puntos seguros, completa las acciones locales indispensables para registrar el resultado y libera recursos controlables, como cursores o archivos temporales. El bloque de limpieza no debería intentar terminar el trabajo pendiente: también debe tener una duración limitada y no ocultar la causa de la detención.
Guarda el estado de la tarea en un lugar duradero, asociado a un identificador estable. Como mínimo, registra estados diferenciables, por ejemplo running, completed, cancelled y timed_out, además de la etapa actual y las marcas temporales relevantes. Añade un motivo legible para operadores, sin guardar datos sensibles innecesarios. Actualiza el estado de forma atómica cuando sea posible y considera que el proceso puede morir antes de completar esa actualización.
El resultado expuesto a quien inició la tarea debe distinguir «cancelada» de «fallida por plazo». Si el estado aún no puede confirmarse después de una terminación abrupta, muéstralo como desconocido o pendiente de verificación, no como completado. Las métricas y los registros estructurados pueden incluir duración, etapa y tipo de detención; evita registrar secretos, contenido privado o trazas sin control de acceso.
Decide si los efectos parciales se pueden reanudar
Una interrupción puede ocurrir después de escribir datos y antes de registrar que la etapa terminó. Por eso, decidir si se puede reanudar no consiste únicamente en guardar el número de etapa: hay que entender qué efectos pudieron producirse. Para operaciones locales, una transacción puede agrupar cambios relacionados si su duración y el motor lo permiten. No mantengas una transacción abierta durante una larga llamada externa.
Para trabajo por lotes, registra unidades completadas con una clave estable y define cuándo una unidad está realmente confirmada. Si al reiniciar se repite una escritura, el diseño debe impedir duplicados o reconocer que el efecto ya existe. Una integración externa que no ofrece cancelación puede haber aceptado una solicitud aunque el cliente haya dejado de esperar; el estado debe reflejar esa incertidumbre, no asumir que no hubo efecto.
Si no es seguro continuar desde el último punto guardado, marca la tarea para revisión o para una recuperación específica. Reanudar automáticamente desde un marcador impreciso puede producir un resultado incorrecto. Documenta qué etapas son repetibles, cuáles requieren verificación y qué condiciones permiten declarar el proceso completo.
Prueba los límites y las interrupciones
Las pruebas deben verificar tanto la detención como el estado final, no solo que se lanzó una excepción. Usa dependencias controlables para simular una llamada lenta, una consulta que supera su plazo y una respuesta que llega justo al límite. Comprueba que el tiempo de una etapa no permita ignorar el deadline global.
Prueba una cancelación entre etapas y durante una operación que solo admite detenerse al regresar. Simula también una terminación abrupta en puntos relevantes: después de un efecto externo, antes de guardar el estado y durante la limpieza. Tras reiniciar el worker, verifica que el estado sea comprensible y que la política de reanudación no duplique ni omita trabajo. Estas pruebas deben usar datos aislados y no depender de servicios externos reales.
Lista de comprobación para un proceso existente
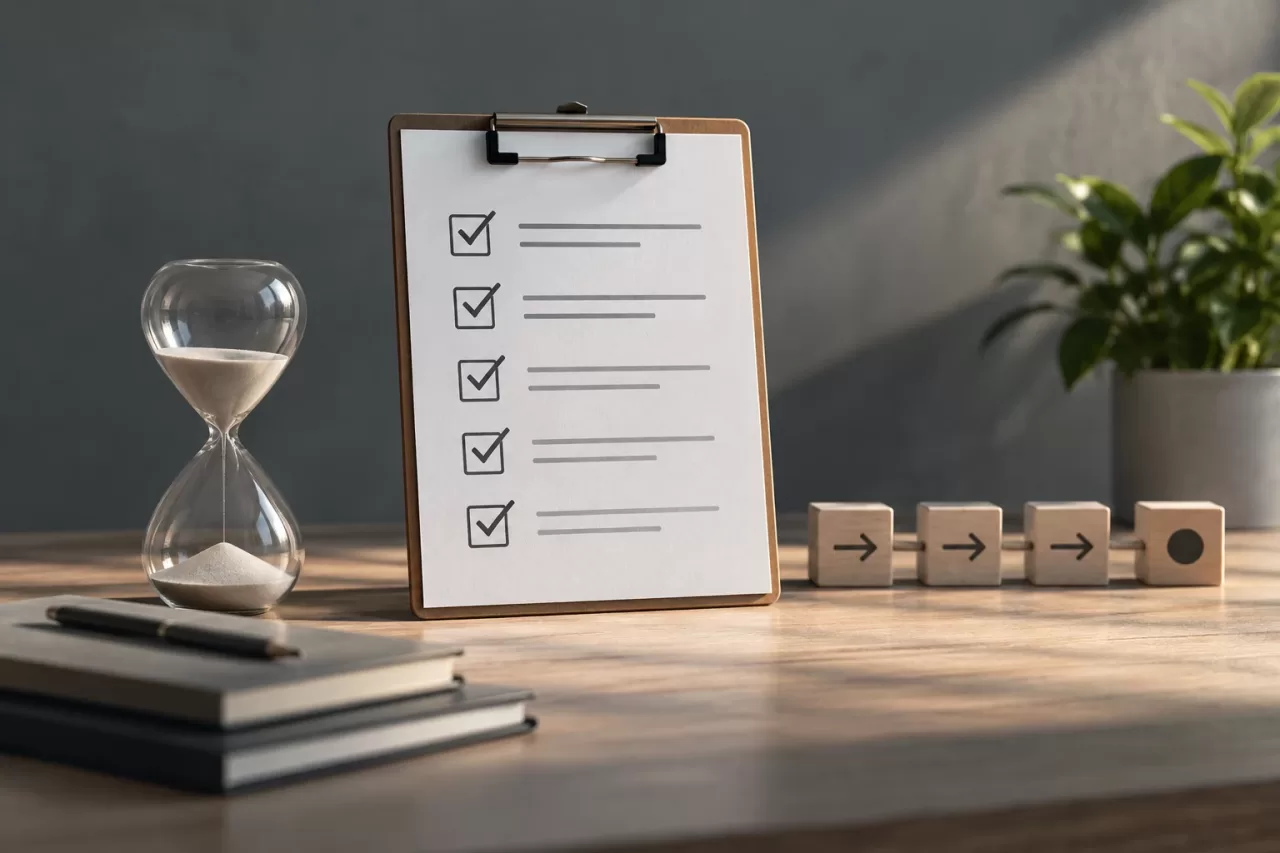
- Identifica límites de PHP, del servidor, del worker y de cada cliente utilizado.
- Define un deadline global y presupuestos por etapa que no lo excedan en conjunto.
- Propaga el tiempo restante a HTTP, base de datos y otros procesos cuando sea posible.
- Comprueba la cancelación en puntos seguros y evita iniciar trabajo nuevo tras recibirla.
- Persiste estados diferenciados, etapa actual y causa de finalización.
- Describe qué efectos parciales pueden quedar y qué condiciones permiten reanudar.
- Prueba demoras, cancelaciones, terminaciones abruptas y el estado observado tras reiniciar.
Un diseño sólido no promete que toda operación pueda detenerse instantáneamente. Hace explícito el tiempo disponible, limita la espera en cada dependencia y conserva información suficiente para interpretar una interrupción. Esa combinación permite que un proceso largo deje de ser una ejecución opaca y se convierta en una unidad operable y verificable.