Un ripristino selettivo dei dati nelle applicazioni PHP consente di recuperare record specifici dopo una cancellazione o una modifica accidentale, senza sostituire l’intero database. La difficoltà non consiste solo nel recuperare una copia precedente: bisogna decidere quale stato ripristinare e proteggere le modifiche valide avvenute in seguito.
La procedura va trattata come un’operazione controllata sui dati di produzione, non come una normale importazione. Prima di eseguirla, è opportuno definirne l’ambito, confrontare lo stato recuperabile con quello attuale, provare il piano e concordare chi deve approvarlo. In questo modo si riducono le sorprese e si rende esplicito che cosa si può e non si può annullare.
Scegliere tra ripristino del servizio, ripristino completo e selettivo
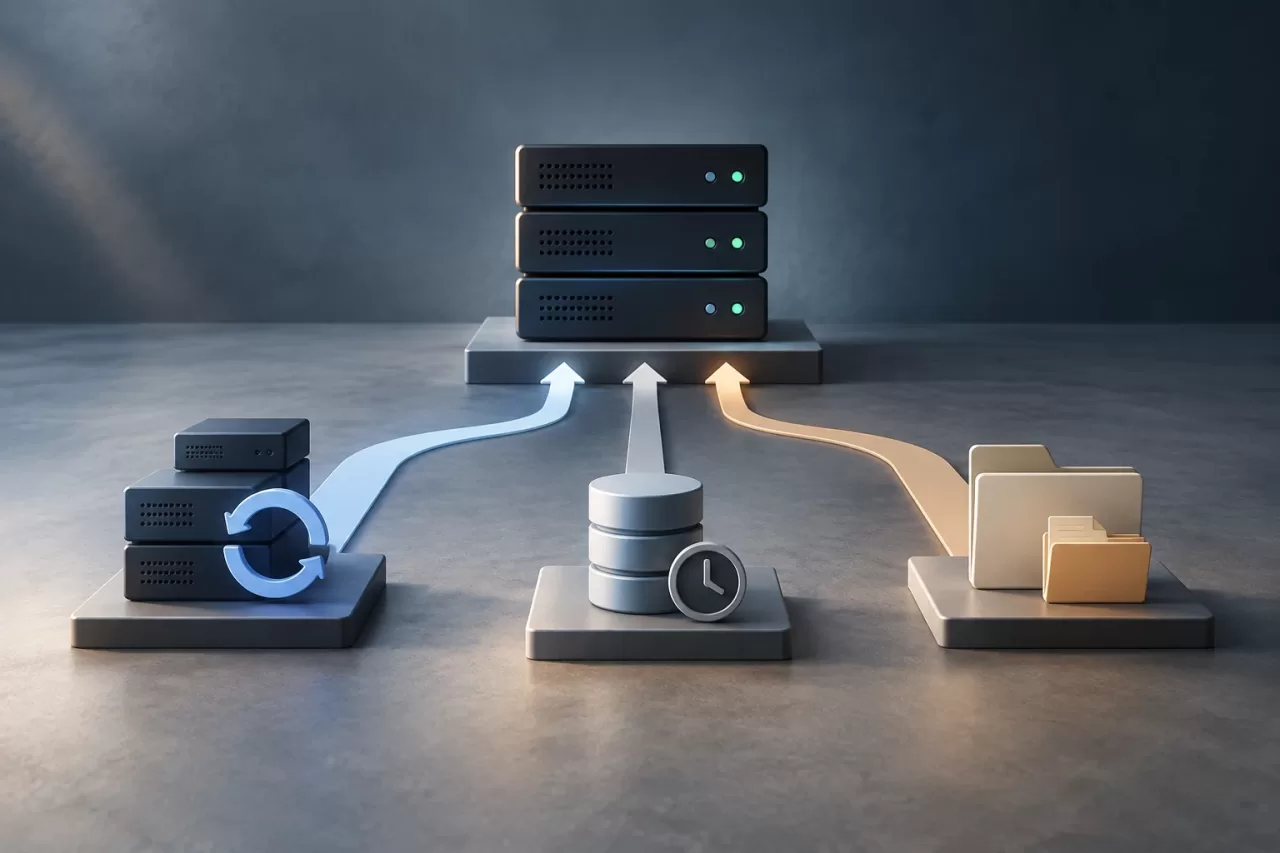
Il ripristino del servizio punta a rendere nuovamente disponibile l’applicazione. Può comportare il ripristino dell’infrastruttura, il passaggio a una replica o il recupero di una copia, ma non risolve necessariamente quali dati vadano conservati. Il ripristino completo sostituisce un ampio insieme di dati con uno stato precedente. È adatto in caso di danni estesi, quando l’obiettivo è riportare il sistema a un determinato momento, ma può eliminare modifiche successive legittime.
Il ripristino selettivo si limita a entità o operazioni specifiche: per esempio, recuperare un insieme di fatture cancellate, correggere campi alterati o ricostruire record relativi a una determinata relazione. È utile quando il resto dell’applicazione ha continuato a funzionare e i dati successivi devono essere mantenuti. Tuttavia, non equivale a copiare righe precedenti: occorre individuare le dipendenze e risolvere le differenze rispetto allo stato corrente.
La scelta dipende dalla causa e dall’estensione dell’incidente. Se non è chiaro che cosa sia stato modificato, bisogna prima indagare e preservare le prove; un ripristino alla cieca può complicare la diagnosi. Se il problema riguarda molte entità correlate o si è verificata una corruzione generalizzata, un ripristino completo o point-in-time può essere più sicuro. La scelta deve basarsi sul danno osservato, non solo sulla comodità dell’operazione.
Definire record, relazioni e operazioni da proteggere
Definire “che cosa ripristinare” richiede di tradurre l’incidente in criteri verificabili. Specificare le tabelle o gli aggregati interessati, le chiavi dei record, il periodo rilevante e le operazioni considerate danneggiate. Evitare criteri ambigui come “tutto quello di ieri”: un intervallo può includere transazioni corrette che non devono essere annullate.
- Entità: identificare i record principali e i dati dipendenti che fanno parte della stessa unità aziendale.
- Periodo: annotare quando si è verificato l’errore e quali timestamp, audit o identificatori permettono di circoscrivere i record candidati.
- Esclusioni: indicare quali modifiche successive devono essere mantenute, come pagamenti confermati, stati degli ordini o dati inseriti dagli utenti.
- Ambito tecnico: registrare l’ambiente, il database e le tabelle incluse, oltre a qualsiasi processo che vi scriva.
Un’applicazione PHP può modificare i dati tramite richieste web, job in background, integrazioni o comandi da console. Prima di ripristinare, individuare questi processi di scrittura e valutare se vadano sospesi o limitati. Se continuano ad aggiornare le stesse entità durante l’operazione, il confronto può diventare obsoleto prima ancora di applicare le modifiche.
Risolvere dipendenze e conflitti prima di scrivere
Le righe spesso dipendono le une dalle altre tramite chiavi esterne o regole di business. Una fattura può dipendere da un cliente e avere associate righe, pagamenti o record di audit. Ripristinare solo la riga principale può lasciare riferimenti non validi; ripristinare l’intero insieme senza analisi può duplicare effetti o riaprire uno stato già chiuso.
Costruire una mappa delle dipendenze e determinare un ordine compatibile con i vincoli. In generale, prima si ripristinano le entità referenziate e poi quelle che ne dipendono; per eliminare o sostituire dati, l’ordine può essere inverso. Non dare per scontato che l’ordine delle tabelle rifletta quello del business. I vincoli del database aiutano a rilevare le incoerenze, ma non sostituiscono i controlli dell’applicazione.
Prima di applicare una copia recuperabile, confrontare ogni elemento candidato con lo stato attuale. La copia è una fonte di prova di uno stato precedente, non necessariamente la verità definitiva. Classificare i casi, per esempio, come record assente, non modificato successivamente, modificato dopo la copia o creato in seguito. Se una riga è cambiata da allora, non sovrascriverla automaticamente: verificare quali campi differiscono e decidere se ripristinarla, combinarla o lasciarla intatta.
Una strategia sicura può produrre un elenco di conflitti da sottoporre a revisione, invece di forzarne la risoluzione. In PHP, la logica applicativa può preparare il piano e verificare le regole di dominio, mentre le transazioni del database proteggono l’insieme delle scritture, se il motore e l’operazione lo consentono. Se il volume o la durata superano ciò che è ragionevole gestire in un’unica transazione, suddividere il lavoro in batch idempotenti e registrare i progressi, così da poterlo riprendere in modo controllato.
Provare, approvare ed eseguire mantenendo la tracciabilità
La prova va eseguita su una copia isolata e rappresentativa, adottando misure adeguate a proteggere i dati sensibili. Eseguire la stessa procedura prevista per la produzione e generare un’anteprima: numero di record candidati, modifiche proposte, esclusioni, conflitti e controlli non superati. L’anteprima deve poter essere esaminata da qualcuno che comprenda l’impatto sul business, non solo l’SQL.
- Preservare lo stato attuale: confermare che esista una copia recuperabile e acquisire lo stato precedente all’intervento. Verificare che la copia sia accessibile e corrisponda all’ambiente previsto.
- Preparare il piano: identificare chiavi specifiche, dipendenze, ordine delle operazioni e condizioni che interromperanno il processo.
- Provare: eseguire la procedura in un ambiente non produttivo e confrontare i risultati con i criteri concordati. Includere casi con modifiche successive e relazioni mancanti.
- Esaminare e approvare: documentare chi convalida l’ambito e chi autorizza l’esecuzione. Se emergono conflitti imprevisti, analizzarli di nuovo invece di ampliare automaticamente l’ambito.
- Eseguire e verificare: applicare le modifiche in una finestra controllata, monitorare gli errori e confrontare i dati ripristinati con le regole di business.
Registrare la richiesta, il responsabile, l’approvazione, la copia utilizzata, le chiavi interessate, l’esito dei controlli e qualsiasi intervento manuale. Evitare di salvare nei log tecnici informazioni sensibili non necessarie. Questa tracciabilità agevola gli audit e aiuta a distinguere lo stato ripristinato dalle modifiche successive.
Convalidare l’integrità e preparare il rollback
L’operazione non termina quando la scrittura restituisce un esito positivo. Verificare che non vi siano riferimenti orfani, duplicati imprevisti o vincoli violati. Convalidare anche gli invarianti di business: totali coerenti, stati consentiti e relazioni che il database potrebbe non esprimere come vincoli. Esaminare gli effetti derivati, come indici di ricerca, cache, eventi in sospeso o sistemi esterni; il ripristino di una riga non annulla necessariamente una notifica già inviata né corregge una proiezione non aggiornata.
Definire in anticipo che cosa significhi interrompere o annullare l’operazione. Una transazione consente di annullare le scritture mentre è ancora aperta, ma non copre automaticamente gli effetti esterni già prodotti. Per un’esecuzione in batch, il rollback può richiedere la registrazione dei valori precedenti e una procedura compensativa. Non eseguire un secondo ripristino improvvisato sopra il primo: potrebbe sovrascrivere altre modifiche. Verificare lo stato e applicare un rollback già provato, con un’approvazione equivalente.
Esercitare la procedura e riconoscerne i limiti
Provare scenari rappresentativi: cancellazione accidentale, modifica parziale, record alterato dopo la copia ed entità con relazioni dipendenti. Misurare i tempi di preparazione e di esecuzione, verificare i permessi e documentare chi decide in caso di conflitto. Una guida che descrive solo il percorso ideale non è sufficiente: deve includere criteri di arresto, contatti responsabili e procedure di comunicazione.
Il ripristino selettivo ha dei limiti. Può risultare impraticabile se non esistono copie recuperabili abbastanza recenti, se mancano identificatori affidabili o se la modifica accidentale si è propagata a sistemi esterni senza tracciabilità. In questi casi, potrebbe essere necessario ricostruire i dati da altre fonti o scegliere un ripristino più ampio. La decisione deve esplicitare quali informazioni saranno conservate, quali andranno perse e quale incertezza rimarrà.
Una procedura collaudata trasforma un’azione rischiosa in una decisione verificabile: definisce dati ed esclusioni, confronta gli stati, rende visibili i conflitti e convalida il risultato prima di chiudere l’incidente. Per i team che mantengono applicazioni PHP con dati critici, questa preparazione è importante quanto disporre di un backup.