Une restauration sélective des données dans des applications PHP permet de récupérer des enregistrements précis après une suppression ou une modification accidentelle, sans remplacer toute la base de données. La difficulté ne consiste pas seulement à obtenir une copie antérieure : il faut décider quel état récupérer et protéger les modifications valides intervenues depuis.
Cette procédure doit être considérée comme une opération contrôlée sur des données de production, et non comme une importation de routine. Avant de l’exécuter, il convient de définir le périmètre, de comparer l’état récupérable à l’état actuel, de tester le plan et de convenir des personnes chargées de l’approuver. Cela réduit les surprises et explicite ce qui peut ou non être annulé.
Choisir entre la reprise du service, la restauration complète et la restauration sélective
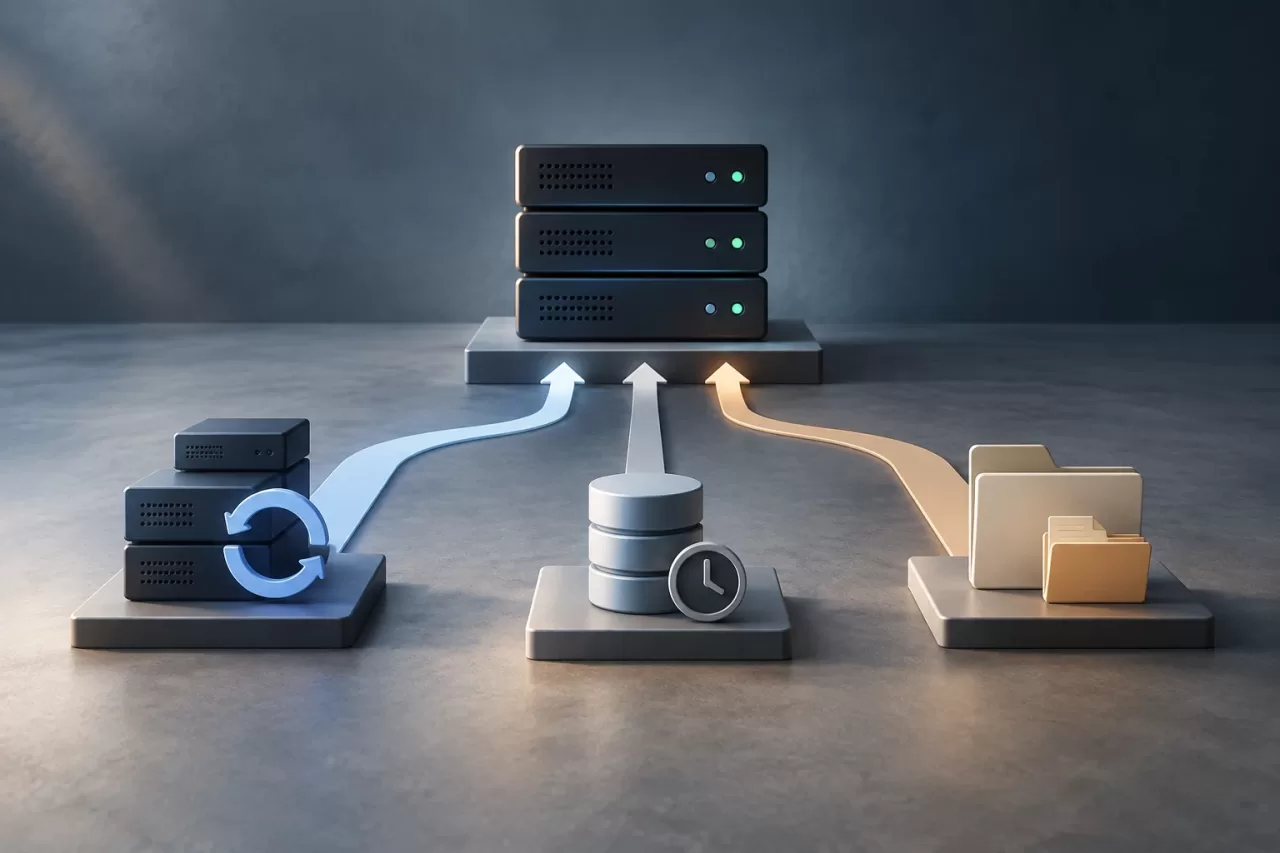
La reprise du service vise à rendre l’application de nouveau disponible. Elle peut impliquer la restauration de l’infrastructure, le basculement vers une réplique ou la récupération d’une copie, mais ne permet pas nécessairement de déterminer quelles données doivent être conservées. La restauration complète remplace un vaste ensemble de données par un état antérieur. Elle convient en cas de dommages étendus lorsque l’objectif est de ramener le système à un point dans le temps, mais elle peut supprimer des modifications légitimes effectuées depuis.
La restauration sélective se limite à des entités ou à des opérations déterminées : par exemple, récupérer un ensemble de factures supprimées, corriger des champs modifiés ou reconstruire les enregistrements d’une relation précise. Elle est utile lorsque le reste de l’application a continué à fonctionner et que les données ultérieures doivent être conservées. Toutefois, elle ne consiste pas à copier d’anciennes lignes : elle exige d’identifier les dépendances et de résoudre les différences avec l’état en vigueur.
Le choix dépend de la cause et de l’étendue de l’incident. Si l’on ignore ce qui a été modifié, il faut d’abord enquêter et préserver les éléments de preuve ; une restauration à l’aveugle peut compliquer le diagnostic. Si le problème touche de nombreuses entités liées ou qu’une corruption généralisée s’est produite, une restauration complète ou à un point dans le temps peut être plus sûre. La sélection doit s’appuyer sur les dommages observés, et non sur la seule facilité de l’opération.
Délimiter les enregistrements, les relations et les opérations à protéger
Définir « ce qu’il faut récupérer » nécessite de traduire l’incident en critères vérifiables. Précisez les tables ou agrégats concernés, les clés des enregistrements, la période pertinente et les opérations considérées comme endommagées. Évitez les critères ambigus comme « tout ce qui date d’hier » : une période peut inclure des transactions correctes qui ne doivent pas être annulées.
- Entités : identifiez les enregistrements principaux et les données dépendantes qui font partie de la même unité métier.
- Période : notez quand l’erreur s’est produite et quels horodatages, audits ou identifiants permettent de délimiter les éléments concernés.
- Exclusions : indiquez les modifications ultérieures à conserver, comme les paiements confirmés, les états des commandes ou les données saisies par les utilisateurs.
- Périmètre technique : consignez l’environnement, la base de données et les tables incluses, ainsi que tout processus qui y écrit.
Une application PHP peut modifier des données au moyen de requêtes web, de tâches en arrière-plan, d’intégrations ou de commandes en ligne de commande. Avant la restauration, repérez ces processus d’écriture et évaluez s’il faut les suspendre ou les limiter. S’ils continuent à mettre à jour les mêmes entités pendant l’opération, la comparaison risque d’être obsolète avant même l’application des modifications.
Résoudre les dépendances et les conflits avant toute écriture
Les lignes dépendent souvent les unes des autres au moyen de clés étrangères ou de règles métier. Une facture peut dépendre d’un client et être associée à des lignes, des paiements ou des enregistrements d’audit. Restaurer uniquement la ligne principale peut laisser des références rompues ; restaurer l’ensemble sans analyse peut dupliquer des effets ou rouvrir un état déjà clôturé.
Établissez une carte des dépendances et déterminez un ordre compatible avec les contraintes. En général, les entités référencées sont restaurées d’abord, puis leurs dépendantes ; pour supprimer ou remplacer des données, l’ordre peut être inversé. Ne supposez pas que l’ordre des tables reflète l’ordre métier. Les contraintes de la base de données aident à détecter les incohérences, mais ne remplacent pas les validations de l’application.
Avant d’appliquer une copie récupérable, comparez chaque élément candidat à l’état actuel. La copie constitue une preuve d’un état antérieur, pas nécessairement la vérité définitive. Classez les cas, par exemple, selon que l’enregistrement est absent, n’a pas subi de modification ultérieure, a été modifié depuis la copie ou a été créé après celle-ci. Si une ligne a changé depuis, ne la remplacez pas automatiquement : examinez les champs qui diffèrent et décidez s’il faut la restaurer, la fusionner ou la laisser intacte.
Une stratégie sûre peut générer une liste de conflits à examiner au lieu d’imposer une résolution. En PHP, la logique applicative peut préparer le plan et vérifier les règles métier, tandis que les transactions de base de données protègent l’ensemble des écritures lorsque le moteur et l’opération le permettent. Si le volume ou la durée dépassent ce qui est raisonnable pour une seule transaction, répartissez le travail en lots idempotents et consignez la progression afin de pouvoir le reprendre de manière contrôlée.
Tester, faire approuver et exécuter avec traçabilité
Le test doit se dérouler sur une copie isolée et représentative, avec des mesures adéquates pour protéger les données sensibles. Exécutez la même procédure que celle prévue en production et générez un aperçu : nombre d’enregistrements candidats, modifications proposées, exclusions, conflits et validations non satisfaites. Cet aperçu doit pouvoir être examiné par une personne qui comprend l’impact métier, et pas seulement le SQL.
- Préserver l’état actuel : confirmez qu’il existe une copie récupérable et capturez l’état antérieur à l’intervention. Vérifiez que cette copie est accessible et qu’elle correspond à l’environnement prévu.
- Préparer le plan : identifiez les clés précises, les dépendances, l’ordre des opérations et les conditions qui interrompront le processus.
- Tester : exécutez le plan dans un environnement hors production et comparez les résultats aux critères convenus. Incluez des cas avec des modifications ultérieures et des relations manquantes.
- Examiner et faire approuver : consignez qui valide le périmètre et qui autorise l’exécution. Si des conflits imprévus apparaissent, reprenez l’analyse au lieu d’élargir automatiquement le périmètre.
- Exécuter et vérifier : appliquez les modifications dans une fenêtre contrôlée, surveillez les erreurs et comparez les données restaurées aux règles métier.
Consignez la demande, le responsable, l’approbation, la copie utilisée, les clés concernées, le résultat des validations et toute intervention manuelle. Évitez d’enregistrer inutilement des informations sensibles dans les journaux techniques. Cette traçabilité facilite les audits et permet de distinguer l’état restauré des modifications ultérieures.
Valider l’intégrité et préparer le retour arrière
L’opération ne s’achève pas lorsque l’écriture renvoie un succès. Vérifiez l’absence de références orphelines, de doublons inattendus et de contraintes non respectées. Validez également les invariants métier : cohérence des totaux, états autorisés et relations que la base de données n’exprime peut-être pas sous forme de contraintes. Examinez les effets dérivés, tels que les index de recherche, les caches, les événements en attente ou les systèmes externes ; restaurer une ligne n’annule pas nécessairement une notification déjà envoyée et ne corrige pas forcément une projection obsolète.
Définissez à l’avance ce que signifie interrompre ou annuler l’opération. Une transaction permet d’annuler les écritures tant qu’elle est ouverte, mais ne couvre pas automatiquement les effets externes déjà produits. Pour une exécution par lots, un retour arrière peut nécessiter l’enregistrement des valeurs précédentes et une procédure compensatoire. Ne lancez pas une deuxième restauration improvisée par-dessus la première : elle pourrait écraser d’autres modifications. Vérifiez l’état et appliquez un retour arrière testé, avec une approbation équivalente.
Répéter la procédure et reconnaître ses limites
Testez des scénarios représentatifs : suppression accidentelle, modification partielle, enregistrement altéré après la copie et entité ayant des relations dépendantes. Mesurez le temps de préparation et d’exécution, vérifiez les autorisations et consignez qui prend les décisions en cas de conflit. Un guide qui décrit uniquement le scénario idéal ne suffit pas ; il doit inclure des critères d’arrêt, les contacts responsables et les étapes de communication.
La restauration sélective a ses limites. Elle peut être irréalisable en l’absence de copies récupérables suffisamment récentes, si des identifiants fiables font défaut ou si la modification accidentelle s’est propagée à des systèmes externes sans traçabilité. Dans ces cas, il peut être nécessaire de reconstruire les données à partir d’autres sources ou d’opter pour une restauration plus large. La décision doit préciser quelles informations seront conservées, lesquelles seront perdues et quelles incertitudes subsistent.
Une procédure testée transforme une action risquée en une décision auditable : elle délimite les données et les exclusions, compare les états, met les conflits en évidence et valide le résultat avant la clôture de l’incident. Pour les équipes qui maintiennent des applications PHP contenant des données critiques, cette préparation est aussi importante que la disponibilité d’une sauvegarde.