
Una ricerca che trova un documento a cui l’utente non ha accesso ha già fallito, anche se l’interfaccia nasconde il collegamento finale. Nei sistemi documentali, nei fascicoli, nei backoffice e nelle basi di conoscenza, il rischio emerge prima: nell’indice, nei frammenti recuperati, nei metadati mostrati e in una risposta generata a partire da contesto non autorizzato.
La ricerca semantica con permessi in PHP deve trattare l’autorizzazione come parte del recupero, non come un controllo decorativo della vista. L’obiettivo non è solo restituire risultati utili: è garantire che ogni frammento candidato, citazione e risposta derivi esclusivamente da contenuti che il principal autenticato può consultare in quel momento.
Decisioni da definire prima dell’indicizzazione
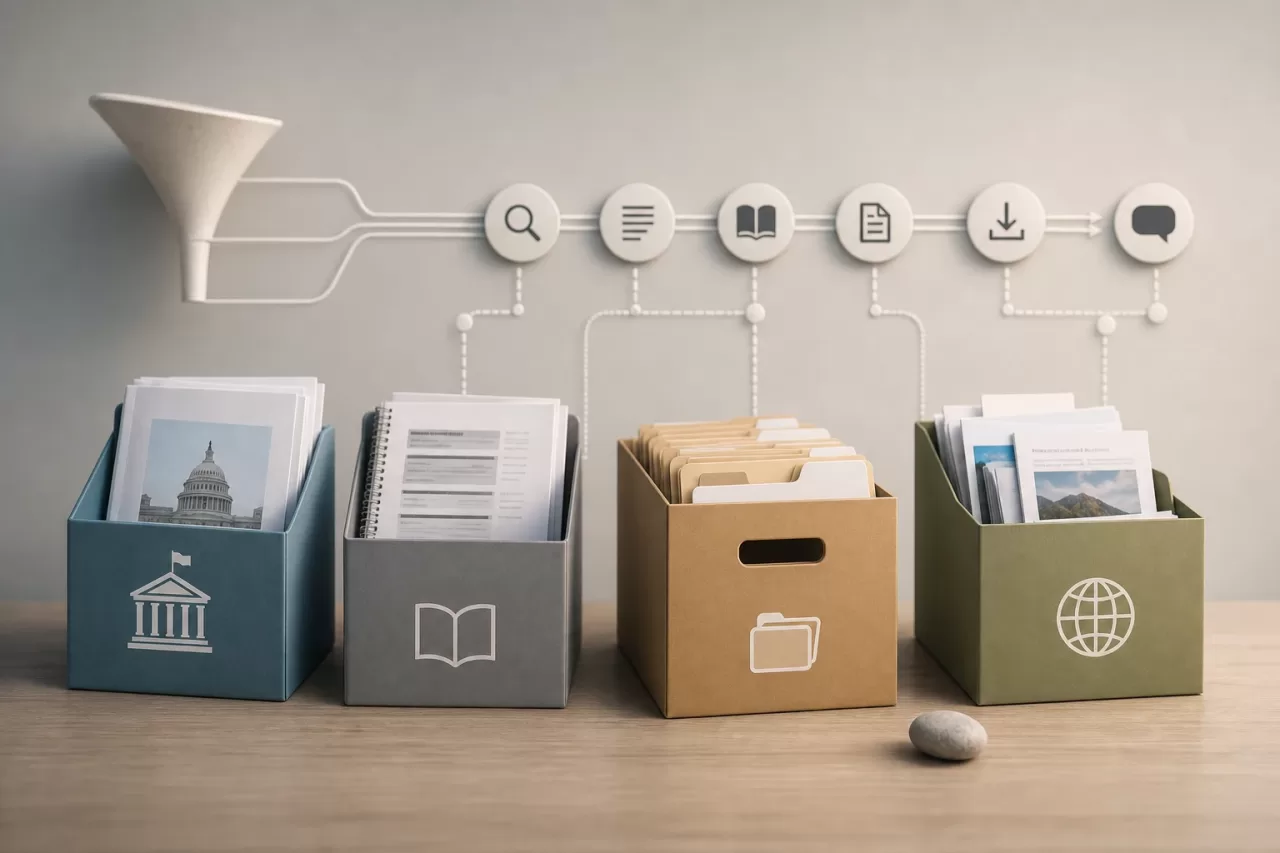
Iniziate definendo il corpus e il relativo modello di accesso. Non tutti i contenuti hanno lo stesso ciclo di vita né la stessa sensibilità: una policy pubblica, un manuale interno, un fascicolo e un file condiviso esternamente richiedono regole diverse. Dovete inoltre decidere quale azione abilita la ricerca: individuare un titolo, leggere un estratto, aprire il documento, scaricare un allegato o richiedere un riepilogo. Avere il permesso di discovery non implica necessariamente il permesso di lettura.
- Principal: utente, account di servizio o sessione delegata che esegue la query.
- Ambito: organizzazione, workspace, progetto, fascicolo o repository in cui può effettuare ricerche.
- Azione: scoprire, leggere, scaricare o amministrare.
- Risorsa: documento e frammento, con relativo stato, classificazione e appartenenza.
- Tolleranza all’errore: nell’autorizzazione deve prevalere il non rivelare; un falso negativo è fastidioso, un falso positivo può essere una violazione.
La similarità vettoriale non comprende le regole di business. Un embedding rappresenta la prossimità di significato, non la legittimità dell’accesso. Per questo il design non può fare affidamento sul fatto che un risultato “simile” sia sicuro né sul fatto che un modello generativo ignori il contesto inappropriato.
Architettura di riferimento e fonte di verità
Conservate i permessi in una fonte di verità transazionale: l’applicazione PHP, il relativo database o il sistema documentale che governa le risorse. L’indice è una proiezione recuperabile, non l’autorità che decide l’accesso. Se l’indice si corrompe, è in ritardo o riceve dati incompleti, il livello di autorizzazione deve poter impedire la consegna.
Un flusso robusto separa quattro fasi:
- Il contenuto viene estratto da una versione identificabile del documento e suddiviso in frammenti con confini coerenti.
- Vengono calcolate rappresentazioni per il recupero e archiviate insieme ai metadati di ambito e versione.
- La query costruisce un filtro autorizzabile per il principal e recupera candidati solo all’interno di tale ambito.
- L’applicazione ricontrolla permesso e validità per ogni candidato prima di mostrarlo o usarlo come contesto.
In PHP, incapsulate queste responsabilità. Un servizio di policy deve risolvere can($principal, 'read', $documento); un adattatore dell’indice deve ricevere filtri derivati da tale decisione; e l’assemblatore dei risultati deve accettare solo candidati verificati. Evitate che controller, template o prompt compongano autonomamente filtri dei permessi.
Metadati che consentono di filtrare senza indovinare
Ogni documento e frammento necessita di un identificatore stabile dell’organizzazione e della risorsa, di una versione del contenuto, dello stato di indicizzazione e di un riferimento al documento padre. Aggiungete gli attributi necessari per esprimere la policy, ma non replicate dati sensibili senza necessità.
- tenant_id o organizzazione: barriera obbligatoria in ambienti multi-tenant.
- document_id e chunk_id: tracciabilità dal risultato fino alla fonte.
- acl_revision: versione della policy applicata durante l’indicizzazione.
- audience: ambito semplice, come pubblico interno, team, progetto o fascicolo.
- lifecycle_state: attivo, archiviato, eliminato o in attesa di revisione.
- content_revision: evita di citare una versione già sostituita.
Non indicizzate un elenco enorme di utenti per frammento se la policy si basa su gruppi variabili: aumenta il costo, espone relazioni e invecchia male. È preferibile filtrare per ambiti stabili quando possibile e risolvere le eccezioni nella verifica successiva. Se il motore di recupero non supporta filtri affidabili, non deve ricevere contenuti di più ambiti di sicurezza nello stesso spazio interrogabile.
Filtrare prima del recupero e verificare dopo
Il prefiltraggio riduce la superficie di esposizione: la query semantica deve includere organizzazione, stato attivo e gli ambiti consentiti prima di calcolare i candidati finali. Così si evita che testo vietato influenzi il ranking, gli estratti o il contesto di una risposta assistita.
La verifica successiva resta necessaria. I permessi possono cambiare tra la query e la lettura, un’ereditarietà può dipendere da un dato non proiettato oppure l’indice può essere in ritardo. Per ogni candidato, recuperate il documento corrente o consultate una cache di autorizzazione con invalidazione sicura. Se il controllo fallisce, scartate il frammento senza rivelarne titolo, punteggio né esistenza.
In presenza di generazione assistita, fornite al modello solo frammenti già autorizzati e verificati. Definite un caso d’uso concreto, come riassumere i risultati recuperati; valutate le risposte con casi consentiti e vietati; conservate citazioni verificabili; limitate il costo per query; e mantenete un’alternativa non generativa, come un elenco di risultati. Un modello non sostituisce la policy di accesso né il controllo umano sui contenuti sensibili.
Ereditarietà, link e revoche che rompono design semplici
I gruppi, le cartelle ereditate e i link condivisi introducono modifiche indirette. Una persona che lascia un gruppo, un documento che cambia cartella o un link che scade devono influire sia sull’apertura sia sul recupero. Modellate esplicitamente la precedenza tra permessi diretti, ereditarietà e dinieghi, e testate i conflitti.
Le revoche richiedono una strategia più rigorosa delle concessioni. Pubblicate eventi di modifica del contenuto e dell’ACL tramite una coda transazionale o un registro delle modifiche; un worker ricalcola i metadati ed elimina o reindicizza i frammenti. Mentre l’indice converge, la verifica successiva protegge la consegna. Per le eliminazioni, contrassegnate immediatamente la risorsa come non disponibile nella fonte di verità e rimuovete i relativi frammenti in modo asincrono, con avvisi se il ritardo supera l’obiettivo operativo.
Risultati verificabili, test e osservabilità
Mostrate titolo, estratto limitato, posizione e data solo se anche questi campi sono leggibili. Ogni risultato deve condurre alla risorsa originale autorizzata; una citazione non deve rivelare un percorso, un autore o testo di un documento nascosto. In assenza di risultati, usate un messaggio neutro: non confermate se esiste contenuto al di fuori dell’ambito dell’utente.
Costruite una matrice di test con utenti di organizzazioni diverse, membri e non membri di gruppi, amministratori con privilegi limitati, link scaduti e risorse revocate durante una sessione. Testate query dirette, sinonimi, termini rari e domande progettate per attirare contenuti vietati. I risultati attesi includono elenchi vuoti quando tutto ciò che è rilevante è precluso.
Registrate, senza archiviare query sensibili non necessarie, la versione dell’indice, i filtri applicati, il numero di candidati prima e dopo la verifica, la latenza, i dinieghi e il ritardo di sincronizzazione. Un aumento degli scarti successivi può indicare ACL non aggiornate; zero risultati dopo una migrazione può segnalare filtri eccessivi; query tra organizzazioni sono un avviso di isolamento.
Quando scegliere un’altra soluzione e checklist finale
La ricerca semantica non sempre conviene. Per cataloghi piccoli e vocabolario stabile, filtri, ricerca testuale e navigazione gerarchica sono più spiegabili ed economici. Sono preferibili anche quando i permessi sono molto dinamici e il motore non può filtrare in modo sicuro per attributi. Usate il recupero semantico quando apporta valore reale alle query formulate in linguaggio naturale e può essere sostenuto il controllo completo degli accessi.
- La fonte di verità decide l’accesso e l’indice può essere ricostruito.
- Tutti i frammenti dispongono di organizzazione, documento, versione e stato.
- La query filtra prima del recupero e verifica prima della consegna.
- Concessioni, modifiche, revoche ed eliminazioni dispongono di sincronizzazione osservabile.
- Le risposte assistite usano solo contesto autorizzato, citazioni e un’alternativa senza IA.
- I test includono tentativi deliberati di accesso improprio e risultati vuoti.


