
Une recherche qui trouve un document auquel l’utilisateur n’a pas accès a déjà échoué, même si l’interface masque le lien final. Dans les systèmes documentaires, les dossiers, les backoffices et les bases de connaissances, le risque apparaît plus tôt : dans l’index, dans les fragments récupérés, dans les métadonnées affichées et dans une réponse générée à partir d’un contexte non autorisé.
La recherche sémantique avec autorisations en PHP doit traiter l’autorisation comme faisant partie de la récupération, et non comme une vérification décorative de la vue. L’objectif n’est pas seulement de renvoyer des résultats utiles : il s’agit de garantir que chaque fragment candidat, citation et réponse découle exclusivement de contenu que le principal authentifié peut consulter à cet instant.
Décisions à arrêter avant l’indexation
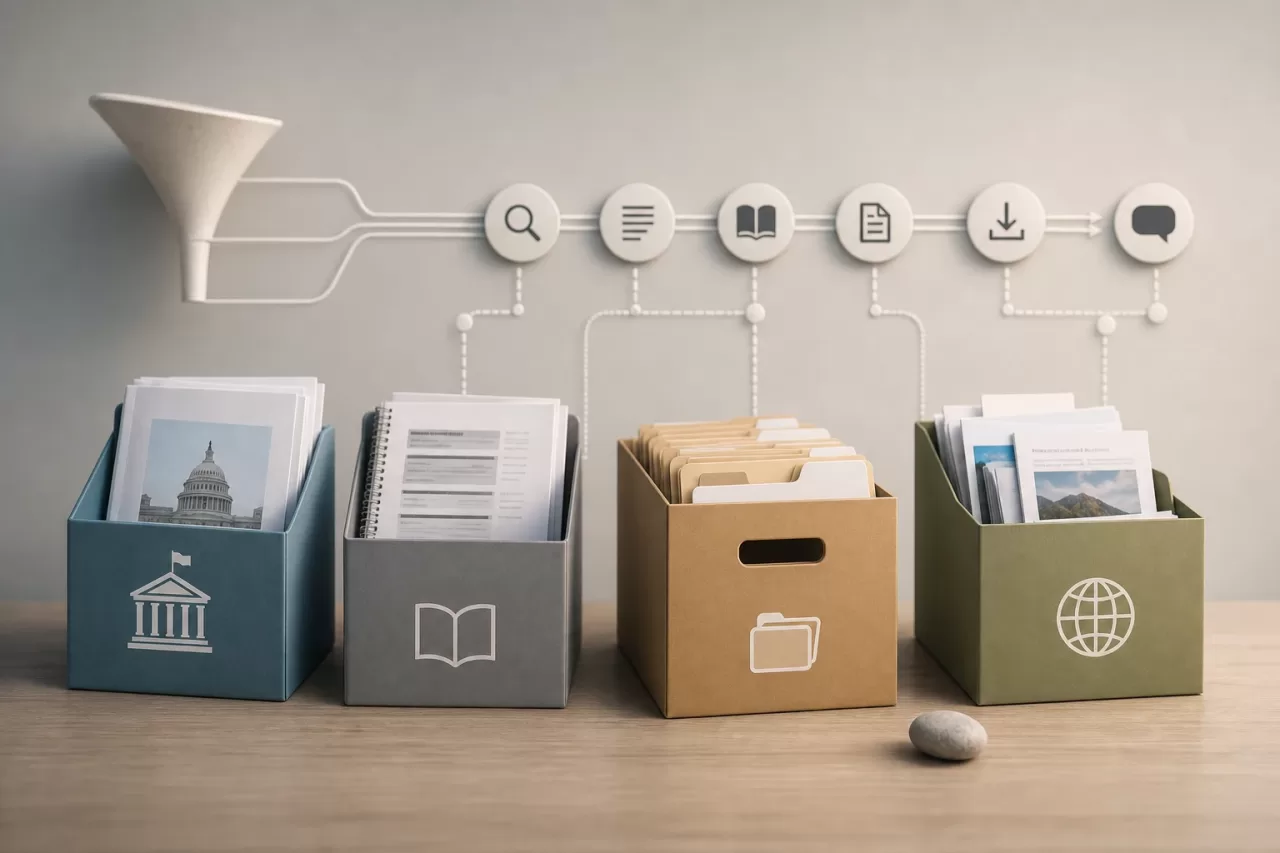
Commencez par définir le corpus et son modèle d’accès. Tous les contenus n’ont pas le même cycle de vie ni la même sensibilité : une politique publique, un manuel interne, un dossier et un fichier partagé en externe nécessitent des règles différentes. Vous devez également décider quelle action la recherche autorise : trouver un titre, lire un extrait, ouvrir le document, télécharger une pièce jointe ou demander un résumé. Avoir l’autorisation de découverte n’implique pas nécessairement l’autorisation de lecture.
- Principal : utilisateur, compte de service ou session déléguée qui effectue la requête.
- Périmètre : organisation, espace de travail, projet, dossier ou dépôt dans lequel il peut effectuer une recherche.
- Action : découvrir, lire, télécharger ou administrer.
- Ressource : document et fragment, avec leur état, leur classification et leur rattachement.
- Tolérance à l’erreur : en matière d’autorisation, ne pas révéler doit prévaloir ; un faux négatif est gênant, un faux positif peut constituer une faille.
La similarité vectorielle ne comprend pas les règles métier. Un embedding représente une proximité de sens, et non la légitimité d’accès. C’est pourquoi la conception ne peut pas se fier au fait qu’un résultat « similaire » soit sûr, ni au fait qu’un modèle génératif ignore le contexte indu.
Architecture de référence et source de vérité
Conservez les autorisations dans une source de vérité transactionnelle : l’application PHP, sa base de données ou le système documentaire qui régit les ressources. L’index est une projection récupérable, et non l’autorité qui décide de l’accès. Si l’index est corrompu, retardé ou reçoit des données incomplètes, la couche d’autorisation doit pouvoir empêcher la restitution.
Un flux robuste sépare quatre étapes :
- Le contenu est extrait d’une version identifiable du document et découpé en fragments aux limites cohérentes.
- Des représentations de récupération sont calculées et enregistrées avec des métadonnées de périmètre et de version.
- La requête construit, pour le principal, un filtre dérivé de ses autorisations et récupère des candidats uniquement dans ce périmètre.
- L’application vérifie à nouveau la permission et la validité de chaque candidat avant de l’afficher ou de l’utiliser comme contexte.
En PHP, encapsulez ces responsabilités. Un service de politiques doit résoudre can($principal, 'read', $document) ; un adaptateur d’index doit recevoir des filtres dérivés de cette décision ; et l’assembleur de résultats ne doit accepter que des candidats vérifiés. Évitez que les contrôleurs, templates ou prompts composent eux-mêmes des filtres d’autorisations.
Métadonnées permettant de filtrer sans deviner
Chaque document et fragment nécessite un identifiant stable d’organisation et de ressource, une version du contenu, un état d’indexation et une référence au document parent. Ajoutez les attributs nécessaires pour exprimer la politique, mais ne répliquez pas de données sensibles sans nécessité.
- tenant_id ou organisation : barrière obligatoire dans les environnements multi-clients.
- document_id et chunk_id : traçabilité du résultat jusqu’à la source.
- acl_revision : version de la politique appliquée lors de l’indexation.
- audience : périmètre simple tel que public interne, équipe, projet ou dossier.
- lifecycle_state : actif, archivé, supprimé ou en attente de révision.
- content_revision : évite de citer une version déjà remplacée.
N’indexez pas une liste gigantesque d’utilisateurs par fragment si la politique repose sur des groupes changeants : cela augmente le coût, expose des relations et vieillit mal. Il est préférable de filtrer par périmètres stables lorsque c’est possible et de résoudre les exceptions lors de la vérification ultérieure. Si le moteur de récupération n’admet pas de filtres fiables, il ne doit pas recevoir de contenu provenant de plusieurs périmètres de sécurité dans le même espace interrogeable.
Filtrer avant de récupérer et vérifier après
Le filtrage préalable réduit la surface d’exposition : la requête sémantique doit inclure l’organisation, l’état actif et les périmètres autorisés avant de calculer les candidats finaux. Cela évite qu’un texte interdit influence le classement, les extraits ou le contexte d’une réponse assistée.
La vérification ultérieure reste nécessaire. Les autorisations peuvent changer entre la requête et la lecture, un héritage peut dépendre d’une donnée non projetée ou l’index peut être retardé. Pour chaque candidat, récupérez le document actuel ou consultez un cache d’autorisation avec une invalidation sûre. Si la vérification échoue, écartez le fragment sans révéler son titre, son score ni son existence.
Lorsqu’il y a génération assistée, ne fournissez au modèle que des fragments déjà autorisés et vérifiés. Définissez un cas d’usage concret, tel que résumer les résultats récupérés ; évaluez les réponses avec des cas autorisés et interdits ; conservez des citations vérifiables ; limitez le coût par requête ; et maintenez une alternative non générative, telle qu’une liste de résultats. Un modèle ne remplace ni la politique d’accès ni le contrôle humain sur les contenus sensibles.
Héritage, liens et révocations qui brisent les conceptions simples
Les groupes, les dossiers hérités et les liens partagés introduisent des changements indirects. Une personne qui quitte un groupe, un document qui change de dossier ou un lien qui expire doivent affecter aussi bien l’ouverture que la récupération. Modélisez explicitement la précédence entre autorisations directes, héritage et refus, et testez les conflits.
Les révocations nécessitent une stratégie plus stricte que les attributions. Publiez les événements de changement de contenu et d’ACL au moyen d’une file transactionnelle ou d’un journal des modifications ; un worker recalcule les métadonnées et supprime ou réindexe les fragments. Pendant que l’index converge, la vérification ultérieure protège la restitution. Pour les suppressions, marquez immédiatement la ressource comme indisponible dans la source de vérité et purgez ses fragments de manière asynchrone, avec des alertes si le délai dépasse l’objectif opérationnel.
Résultats vérifiables, tests et observabilité
Affichez le titre, l’extrait limité, l’emplacement et la date uniquement si ces champs sont également lisibles. Chaque résultat doit mener à la ressource originale autorisée ; une citation ne doit pas révéler un chemin, un auteur ou du texte provenant d’un document masqué. En l’absence de résultats, utilisez un message neutre : ne confirmez pas l’existence de contenu hors du périmètre de l’utilisateur.
Construisez une matrice de tests avec des utilisateurs de différentes organisations, des membres et non-membres de groupes, des administrateurs limités, des liens expirés et des ressources révoquées durant une session. Testez des requêtes directes, des synonymes, des termes rares et des questions conçues pour attirer du contenu interdit. Les résultats attendus incluent des listes vides lorsque tout le contenu pertinent est interdit.
Enregistrez, sans stocker inutilement de requêtes sensibles, la version de l’index, les filtres appliqués, le nombre de candidats avant et après vérification, la latence, les refus et le retard de synchronisation. Une hausse des écartements ultérieurs peut indiquer des ACL obsolètes ; zéro résultat après une migration peut signaler des filtres excessifs ; des requêtes entre organisations constituent une alerte d’isolation.
Quand choisir une autre solution et liste de contrôle finale
La recherche sémantique n’est pas toujours rentable. Pour les petits catalogues et un vocabulaire stable, les filtres, la recherche textuelle et la navigation hiérarchique sont plus explicables et moins coûteux. Ils sont également préférables lorsque les autorisations sont très dynamiques et que le moteur ne peut pas filtrer par attributs de manière sûre. Utilisez la récupération sémantique lorsqu’elle apporte une valeur réelle aux requêtes formulées en langage naturel et que le contrôle d’accès complet peut être maintenu.
- La source de vérité décide de l’accès et l’index peut être reconstruit.
- Tous les fragments ont une organisation, un document, une version et un état.
- La requête filtre avant de récupérer et vérifie avant de restituer.
- Les attributions, modifications, révocations et suppressions disposent d’une synchronisation observable.
- Les réponses assistées n’utilisent qu’un contexte autorisé, des citations et une alternative sans IA.
- Les tests incluent des tentatives délibérées d’accès indu et des résultats vides.


