Quando un assistente risponde con informazioni su un’altra persona o azienda, il problema non riguarda solo la qualità: può trattarsi di una violazione della privacy e del controllo degli accessi. In un’applicazione PHP multiutente, la memoria conversazionale deve essere trattata come un insieme di dati con proprietario, ambito e ciclo di vita definiti. Non basta salvare i messaggi e recuperarli tramite un identificatore di sessione.
L’isolamento del contesto conversazionale nelle applicazioni PHP consiste nel garantire che il materiale utilizzato per generare una risposta appartenga alla conversazione corrente e sia ancora autorizzato. Ciò include i messaggi precedenti, i riepiloghi e tutti i dati recuperati. La ricerca nei documenti può integrare il contesto, ma ha regole di accesso e obiettivi diversi.
Separare memoria conversazionale, cronologia e documenti
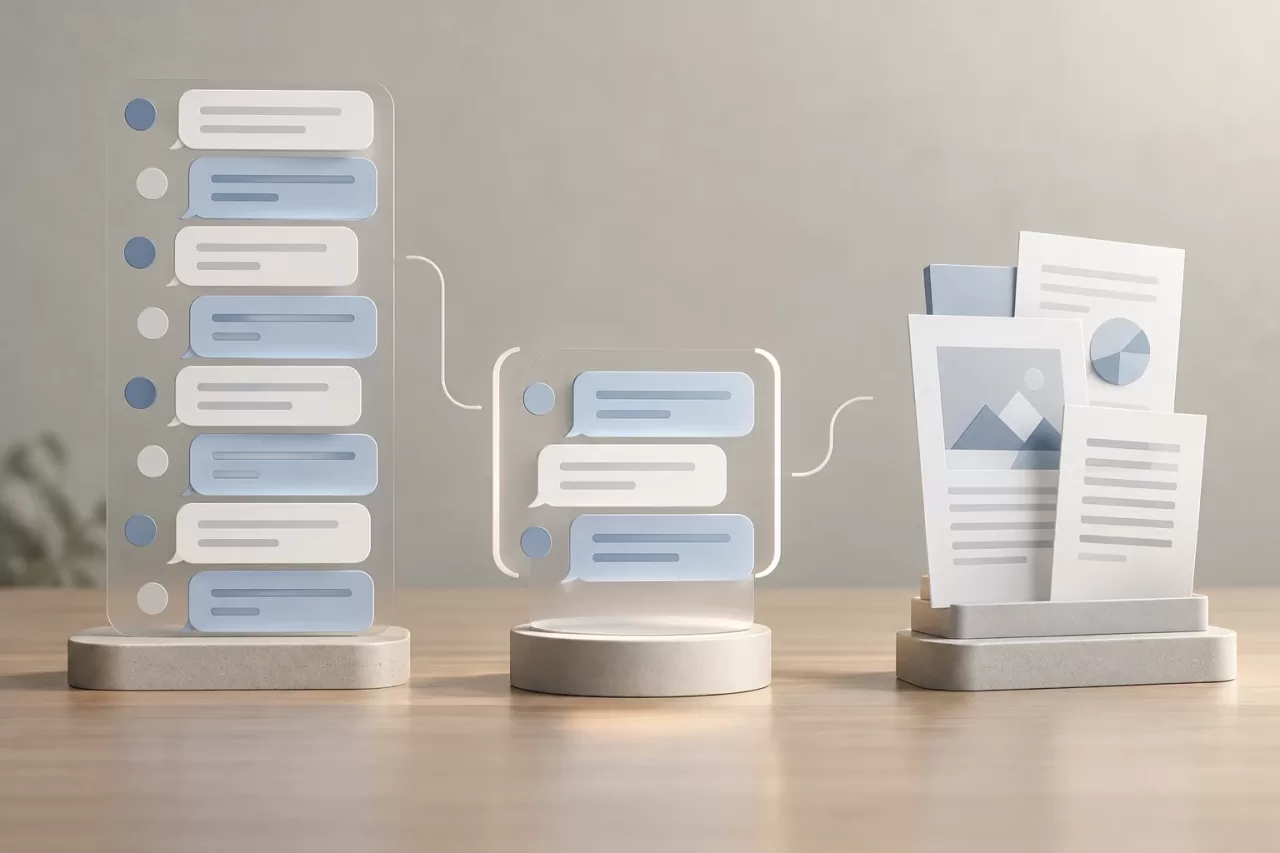
La cronologia completa è il registro dei messaggi di una conversazione. La memoria, invece, è il sottoinsieme che l’applicazione decide di recuperare per un’attività: per esempio, gli ultimi turni o un riepilogo aggiornato. I documenti recuperati tramite ricerca costituiscono un’altra fonte, selezionata in base a una query e alle autorizzazioni sui documenti. Non vanno confusi né salvati come se fossero messaggi pronunciati dall’utente.
Questa distinzione facilita decisioni verificabili. È possibile conservare la cronologia per motivi di audit o di prodotto, limitando al contempo la memoria inviata al modello. Inoltre, ogni frammento documentale può mantenere la propria provenienza e il proprio controllo degli accessi. Se queste fonti vengono mescolate senza identificarle, diventa difficile spiegare quali dati abbiano influenzato una risposta e applicare la relativa policy di conservazione.
Definire chi è proprietario di ogni conversazione
Prima di progettare il recupero, definite un’identità stabile per la conversazione. Come minimo, considerate:
- Conversazione: un identificatore casuale o non prevedibile, senza presumere che conoscerlo conceda l’accesso.
- Utente: l’identità autenticata che ha avviato l’interazione o è autorizzata a consultarla.
- Organizzazione: l’ambito di dati a cui appartiene, se l’applicazione opera con più aziende o spazi di lavoro.
- Autorizzazioni vigenti: l’autorizzazione valutata al momento di ogni lettura, non una copia indefinitamente valida delle autorizzazioni iniziali.
La sessione web può servire ad autenticare una richiesta, ma non dovrebbe essere l’unica chiave di proprietà persistente. Una persona può disconnettersi, cambiare organizzazione o perdere un’autorizzazione mentre una conversazione è ancora archiviata. A ogni richiesta, l’applicazione deve verificare che l’utente corrente possa accedere a quella conversazione nell’organizzazione attiva.
È opportuno definire esplicitamente i cambiamenti di contesto. Se qualcuno cambia organizzazione, può continuare la conversazione precedente, deve avviarne una nuova o può conservare solo un riepilogo approvato? Non esiste una risposta universale: dipende dal prodotto e dai suoi requisiti di privacy. La decisione deve riflettersi in regole verificabili, non in un presupposto implicito dell’interfaccia.
Applicare l’ambito di accesso prima di recuperare il contesto
L’autorizzazione deve far parte della query che recupera i dati, prima che questi vengano inseriti nel prompt. Recuperare prima una raccolta ampia e filtrarla poi in PHP aumenta il rischio che un errore, un percorso alternativo o un log di debug esponga contenuti altrui.
In un database relazionale, la query può includere contemporaneamente l’identificatore della conversazione, l’utente e l’organizzazione autorizzati. Per esempio, a livello concettuale:
SELECT message_id, role, content, created_at
FROM conversation_messages
WHERE conversation_id = :conversation_id
  AND organization_id = :organization_id
  AND conversation_id IN (
      SELECT conversation_id
      FROM conversations
      WHERE owner_user_id = :user_id
         OR EXISTS (/* verificare una concessione vigente */)
  )
ORDER BY created_at DESC
LIMIT :message_limit
Lo schema effettivo può essere diverso, ma l’aspetto fondamentale è che l’ambito di accesso limiti i record recuperati. Usate parametri associati e un livello di autorizzazione coerente per le operazioni di lettura, scrittura, esportazione ed eliminazione. Se si utilizza un database vettoriale o un servizio di ricerca, i vincoli relativi all’organizzazione e alle autorizzazioni devono essere applicati nella query di recupero; non basta chiedere al modello di ignorare i risultati non autorizzati.
Quando la ricerca documentale e la memoria conversazionale vengono combinate, applicate prima l’autorizzazione appropriata a ciascuna fonte. Mantenete i metadati di provenienza ed evitate di trasformare i risultati documentali in memoria permanente senza una policy esplicita.
Evitare commistioni in cache, code e componenti condivisi
Un accesso corretto al database non garantisce l’isolamento se altri livelli condividono lo stato. Una chiave di cache come conversation:123 può essere insufficiente se lo stesso identificatore viene usato in più ambiti, riutilizzato o se una configurazione della cache consente collisioni. Includete nella chiave gli identificatori dell’organizzazione e della conversazione e, quando opportuno, una versione delle autorizzazioni o dei dati. Non usate contenuti sensibili come parte della chiave.
Nei job in background, trasmettete un contesto minimo ed esplicito: organizzazione, conversazione, attore e scopo del job. Al momento dell’esecuzione, convalidate di nuovo che il job disponga ancora dell’autorizzazione e che non stia usando un’identità ricavata da uno stato globale condiviso. Evitate variabili statiche, servizi singleton con dati utente mutabili e oggetti di sessione riutilizzati tra richieste, soprattutto nei processi PHP persistenti.
Definite anche cosa accade in caso di errori e tentativi ripetuti. Un job ritentato non dovrebbe cambiare organizzazione a causa dello stato di un altro processo e una risposta memorizzata in cache non dovrebbe sopravvivere a una revoca se la policy richiede di invalidarla. Il comportamento deve essere intenzionale e osservabile.
Limitare la memoria a ciò che serve per l’attività
Isolare non significa inviare l’intera cronologia al modello. Recuperate i turni recenti o un riepilogo utile per la richiesta corrente, con limiti di quantità e dimensione. Considerate l’attualità: preferenze obsolete, dati corretti e decisioni revocate non dovrebbero essere trattati automaticamente come fatti attuali.
Se si usano riepiloghi, salvate il loro ambito e la loro provenienza e aggiornateli secondo regole chiare. Un riepilogo non è una fonte di verità e non sostituisce la verifica delle autorizzazioni. Per i dati critici, consultate il sistema di riferimento autorizzato invece di fare affidamento su un’informazione salvata in una conversazione precedente. Una finestra di contesto ridotta limita l’esposizione e i costi, ma non compensa un’autorizzazione errata.
Verificare che una conversazione non influisca su un’altra
I test devono coprire sia gli accessi consentiti sia quelli negati. Create casi con utenti e organizzazioni diversi e verificate che una richiesta non recuperi messaggi, riepiloghi o documenti di un’altra identità. Includete situazioni limite:
- Un utente cambia organizzazione e riapre un vecchio identificatore di conversazione.
- Un’autorizzazione viene revocata dopo la creazione della conversazione, ma prima del recupero della relativa memoria.
- Due utenti effettuano consultazioni simultanee e condividono processi, cache o infrastruttura di code.
- Un identificatore inesistente o appartenente ad altri genera una risposta controllata senza rivelare se appartenga a un’altra persona.
- Un job viene ritentato dopo un cambiamento delle autorizzazioni o dell’organizzazione.
Oltre ai test unitari, verificate l’intero percorso dalla richiesta autenticata alla costruzione del contesto. Potete inserire messaggi segnaposto in conversazioni separate e verificare che il risultato recuperato per ciascuna non contenga mai il segnaposto dell’altra. L’obiettivo è verificare il confine dei dati, non valutare se il modello scriva una risposta convincente.
Analizzare gli incidenti senza registrare contenuti sensibili
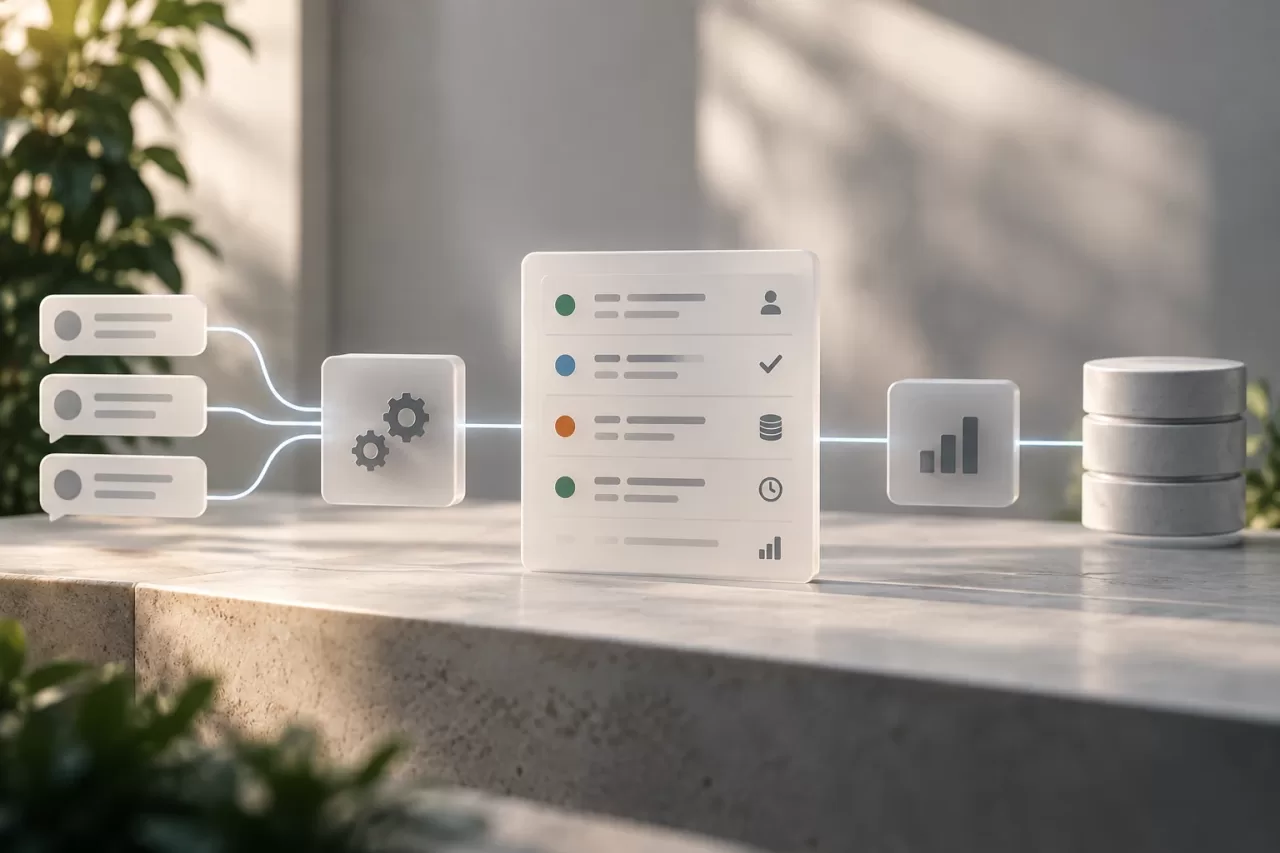
L’osservabilità deve consentire di seguire il flusso senza copiare messaggi privati nei log. Registrate identificatori tecnici adeguati, l’esito della decisione di autorizzazione, il numero di elementi recuperati, la provenienza dei dati, la durata e il risultato di ogni fase. Usate identificatori pseudonimi quando possibile e limitate l’accesso e la conservazione dei log.
Segnali come un recupero inaspettatamente vuoto, un’organizzazione non corrispondente, un tasso insolitamente elevato di dinieghi o una chiave di cache riutilizzata al di fuori del proprio ambito aiutano a individuare i problemi. Evitate di registrare per impostazione predefinita prompt completi, documenti o risposte. Se serve una diagnosi dettagliata, definite una procedura temporanea, autorizzata e circoscritta, con oscuramento dei dati sensibili.
Una progettazione sicura rende espliciti il proprietario, l’ambito e l’attualità di ogni frammento di contesto. Applicare queste regole nelle query, nelle cache e nei job asincroni e verificare i casi negativi rende l’isolamento una proprietà verificabile dell’applicazione PHP, non un’aspettativa affidata all’assistente.