Lorsqu’un assistant répond avec des informations concernant une autre personne ou entreprise, le problème ne relève pas seulement de la qualité : il peut s’agir d’une atteinte à la vie privée et au contrôle d’accès. Dans une application PHP multi-utilisateur, la mémoire conversationnelle doit être traitée comme des données dont le propriétaire, le périmètre et le cycle de vie sont définis. Il ne suffit pas d’enregistrer les messages et de les récupérer à l’aide d’un identifiant de session.
L’isolation du contexte conversationnel dans les applications PHP consiste à garantir que les éléments utilisés pour générer une réponse appartiennent à la conversation en cours et sont toujours autorisés. Cela inclut les messages précédents, les résumés et toutes les données récupérées. La recherche documentaire peut compléter le contexte, mais elle obéit à des règles d’accès et à des objectifs différents.
Distinguer la mémoire conversationnelle, l’historique et les documents
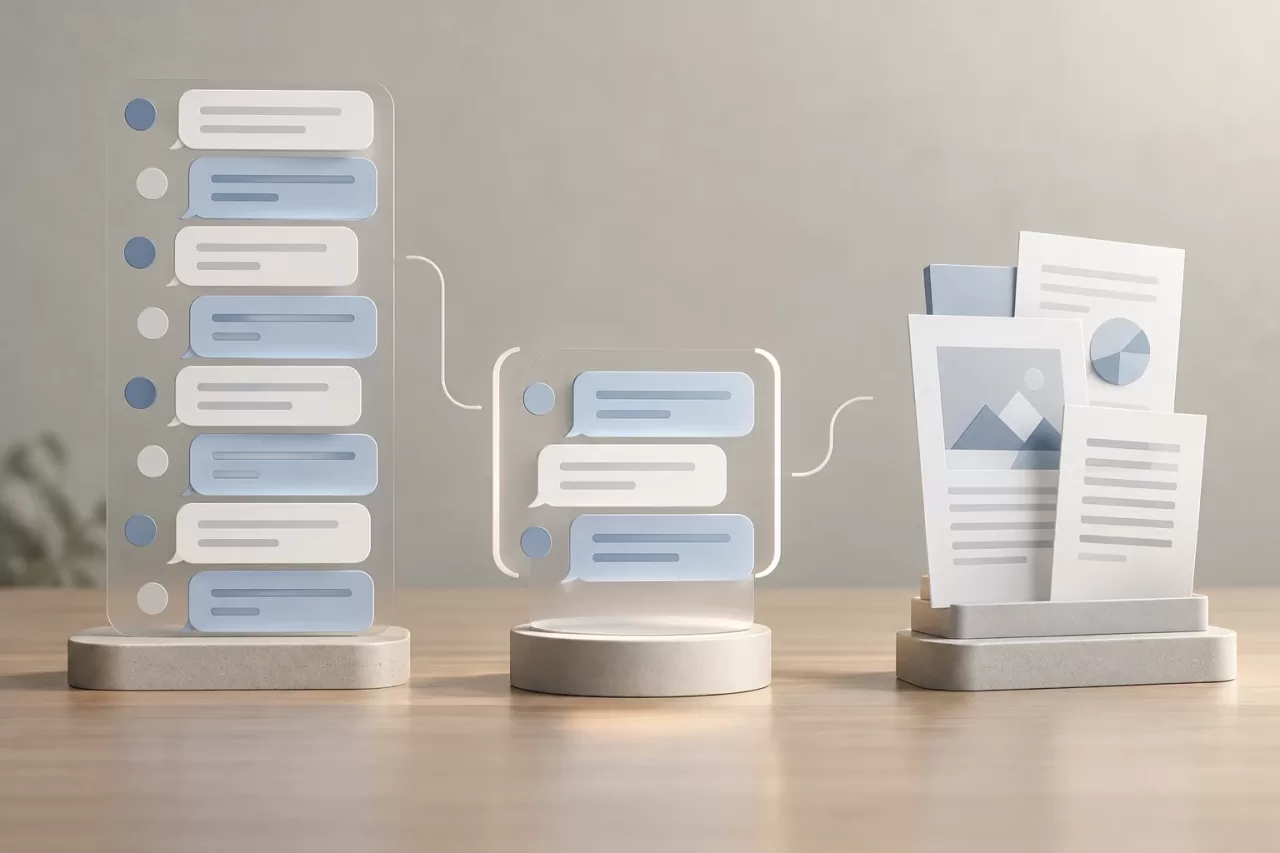
L’historique complet est le journal des messages d’une conversation. La mémoire, en revanche, est le sous-ensemble que l’application choisit de récupérer pour une tâche : par exemple, les derniers échanges ou un résumé actualisé. Les documents récupérés par la recherche constituent une autre source, sélectionnée à partir d’une requête et des autorisations documentaires. Il ne faut pas les confondre ni les enregistrer comme s’il s’agissait de messages prononcés par l’utilisateur.
Cette distinction facilite la prise de décisions vérifiables. L’historique peut être conservé pour des raisons d’audit ou de produit, tandis que la mémoire envoyée au modèle est limitée. De même, chaque fragment documentaire peut conserver sa propre provenance et son propre contrôle d’accès. Si ces sources sont mélangées sans être identifiées, il devient difficile d’expliquer quelles données ont influencé une réponse et d’appliquer leur politique de conservation.
Définir le propriétaire de chaque conversation
Avant de concevoir la récupération, définissez une identité stable pour la conversation. Au minimum, prenez en compte les éléments suivants :
- Conversation : un identifiant aléatoire ou imprévisible, sans supposer que le fait de le connaître confère un accès.
- Utilisateur : l’identité authentifiée qui a démarré l’interaction ou qui est autorisée à la consulter.
- Organisation : le périmètre de données auquel elle appartient, si l’application fonctionne avec plusieurs entreprises ou espaces de travail.
- Autorisations en vigueur : une autorisation évaluée au moment de chaque lecture, et non une copie indéfiniment conservée des autorisations initiales.
La session web peut servir à authentifier une requête, mais ne devrait pas être l’unique clé de propriété persistante. Une personne peut se déconnecter, changer d’organisation ou perdre une autorisation alors qu’une conversation reste stockée. À chaque requête, l’application doit vérifier que l’utilisateur actuel peut accéder à cette conversation au sein de l’organisation active.
Il est utile de définir explicitement les changements de contexte. Si une personne change d’organisation, peut-elle poursuivre la conversation précédente, doit-elle en démarrer une nouvelle ou peut-elle uniquement conserver un résumé approuvé ? Il n’existe pas de réponse universelle : cela dépend du produit et de ses exigences en matière de confidentialité. La décision doit se traduire par des règles vérifiables, et non par une hypothèse implicite de l’interface.
Appliquer le périmètre d’accès avant de récupérer le contexte
L’autorisation doit faire partie de la requête qui récupère les données, avant leur intégration au prompt. Récupérer d’abord une collection étendue puis filtrer en PHP augmente le risque qu’une erreur, un chemin alternatif ou un journal de débogage expose des contenus qui ne devraient pas l’être.
Dans une base de données relationnelle, la requête peut inclure simultanément l’identifiant de conversation, l’utilisateur et l’organisation autorisés. Par exemple, de manière conceptuelle :
SELECT message_id, role, content, created_at
FROM conversation_messages
WHERE conversation_id = :conversation_id
  AND organization_id = :organization_id
  AND conversation_id IN (
      SELECT conversation_id
      FROM conversations
      WHERE owner_user_id = :user_id
         OR EXISTS (/* vérifier une autorisation en vigueur */)
  )
ORDER BY created_at DESC
LIMIT :message_limit
Le schéma réel peut être différent, mais l’essentiel est que le périmètre d’accès restreigne les enregistrements récupérés. Utilisez des paramètres liés et une couche d’autorisation cohérente pour les opérations de lecture, d’écriture, d’exportation et de suppression. Si vous utilisez une base vectorielle ou un service de recherche, les restrictions liées à l’organisation et aux autorisations doivent être appliquées dans la requête de récupération ; il ne suffit pas de demander au modèle d’ignorer les résultats non autorisés.
Lorsque la recherche documentaire et la mémoire conversationnelle sont combinées, appliquez d’abord les autorisations propres à chaque source. Conservez les métadonnées de provenance et évitez de transformer des résultats documentaires en mémoire permanente sans politique explicite.
Éviter les mélanges dans les caches, les files d’attente et les composants partagés
Un accès correct à la base de données ne garantit pas l’isolation si d’autres couches partagent un état. Une clé de cache comme conversation:123 peut être insuffisante si le même identifiant est utilisé dans plusieurs périmètres, réutilisé ou susceptible d’entrer en collision en raison de la configuration du cache. Incluez dans la clé les identifiants de l’organisation et de la conversation ainsi que, le cas échéant, une version des autorisations ou des données. N’utilisez pas de contenu sensible dans la clé.
Dans les tâches en arrière-plan, transmettez un contexte minimal et explicite : organisation, conversation, acteur et objectif de la tâche. Lors de son exécution, vérifiez à nouveau que la tâche dispose toujours de l’autorisation requise et qu’elle n’utilise pas une identité issue d’un état global partagé. Évitez les variables statiques, les services singleton contenant des données utilisateur mutables et les objets de session réutilisés entre les requêtes, en particulier dans les processus PHP persistants.
Définissez également ce qui se passe en cas d’erreur et de nouvelle tentative. Une tâche relancée ne devrait pas changer d’organisation en raison de l’état d’un autre processus, et une réponse stockée dans le cache ne devrait pas persister après une révocation si la politique impose son invalidation. Le comportement doit être délibéré et observable.
Limiter la mémoire à ce qui est nécessaire pour la tâche
Isoler ne signifie pas envoyer tout l’historique au modèle. Récupérez les échanges récents ou un résumé utile à la requête actuelle, en limitant leur nombre et leur taille. Tenez compte de leur actualité : les préférences anciennes, les données corrigées et les décisions révoquées ne devraient pas être automatiquement considérées comme des faits actuels.
Si vous utilisez des résumés, enregistrez leur périmètre et leur provenance, et actualisez-les selon des règles claires. Un résumé n’est pas une source de vérité et ne remplace pas la vérification des autorisations. Pour les données critiques, consultez le système de référence autorisé au lieu de vous fier à une affirmation enregistrée dans une conversation précédente. Une fenêtre de contexte réduite limite l’exposition et les coûts, mais ne compense pas une autorisation incorrecte.
Vérifier qu’une conversation n’influence pas une autre
Les tests doivent couvrir aussi bien les accès autorisés que les accès refusés. Créez des cas avec des utilisateurs et des organisations différents et vérifiez qu’une requête ne récupère ni messages, ni résumés, ni documents associés à une autre identité. Incluez des situations limites :
- Un utilisateur change d’organisation puis rouvre un ancien identifiant de conversation.
- Une autorisation est révoquée après la création de la conversation, mais avant la récupération de sa mémoire.
- Deux utilisateurs effectuent des requêtes simultanément et partagent des processus, un cache ou une infrastructure de files d’attente.
- Un identifiant inexistant ou appartenant à quelqu’un d’autre produit une réponse contrôlée, sans révéler s’il appartient à une autre personne.
- Une tâche est relancée après un changement d’autorisations ou d’organisation.
En plus des tests unitaires, testez le parcours complet, de la requête authentifiée à la construction du contexte. Vous pouvez insérer des messages marqueurs dans des conversations distinctes et vérifier que le résultat récupéré pour chacune ne contient jamais le marqueur de l’autre. L’objectif est de tester la frontière des données, et non d’évaluer si le modèle rédige une réponse convaincante.
Enquêter sur les incidents sans journaliser de contenu sensible
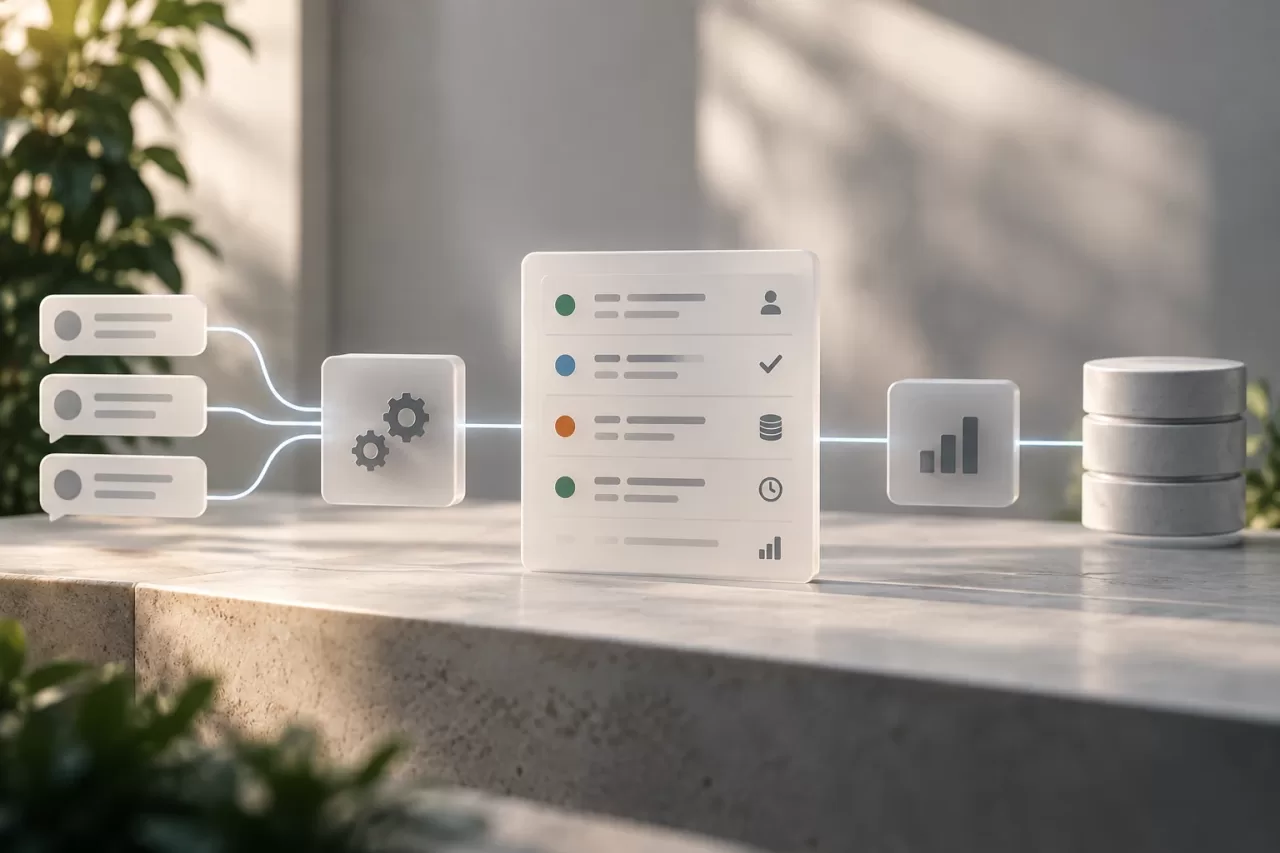
L’observabilité doit permettre de suivre le flux sans copier de messages privés dans les journaux. Enregistrez des identifiants techniques adaptés, la décision d’autorisation, le nombre d’éléments récupérés, la provenance des données, la durée et le résultat de chaque étape. Utilisez des identifiants pseudonymisés dans la mesure du possible et limitez l’accès aux journaux ainsi que leur durée de conservation.
Des indicateurs tels qu’une récupération vide inattendue, une organisation discordante, un taux inhabituel de refus ou une clé de cache réutilisée hors de son périmètre aident à détecter les défaillances. Évitez de journaliser par défaut les prompts complets, les documents ou les réponses. Si un diagnostic détaillé est nécessaire, mettez en place une procédure temporaire, autorisée et limitée, avec masquage des données sensibles.
Une conception sécurisée explicite le propriétaire, le périmètre et la validité de chaque fragment de contexte. Appliquer ces règles dans les requêtes, les caches et les tâches asynchrones, puis vérifier les cas négatifs, fait de l’isolation une propriété vérifiable de l’application PHP, plutôt qu’une attente placée dans l’assistant.