Un journal de sécurité sert à reconstituer qui a tenté de faire quoi, sur quelle ressource, à quel moment et avec quel résultat. Ce n’est ni une copie de toutes les requêtes ni un vidage des exceptions. Son objectif est de fournir des éléments utiles pour enquêter sur les accès et les actions suspectes, avec le minimum de données nécessaire et des contrôles empêchant le journal lui-même de devenir une source d’exposition.
Pour concevoir le logging de sécurité en PHP, il convient d’abord de définir les événements importants et l’usage qui en sera fait : détection, enquête, audit opérationnel ou conformité à une politique interne. Il faut ensuite établir un format commun, décider qui peut consulter les journaux et tester l’ensemble du parcours. Un journal qui existe, mais ne permet pas de trier les événements, d’identifier le résultat ou de distinguer les tentatives des actions terminées, ne répond pas au besoin d’enquête.
Distinguer les journaux techniques, l’activité et les événements de sécurité
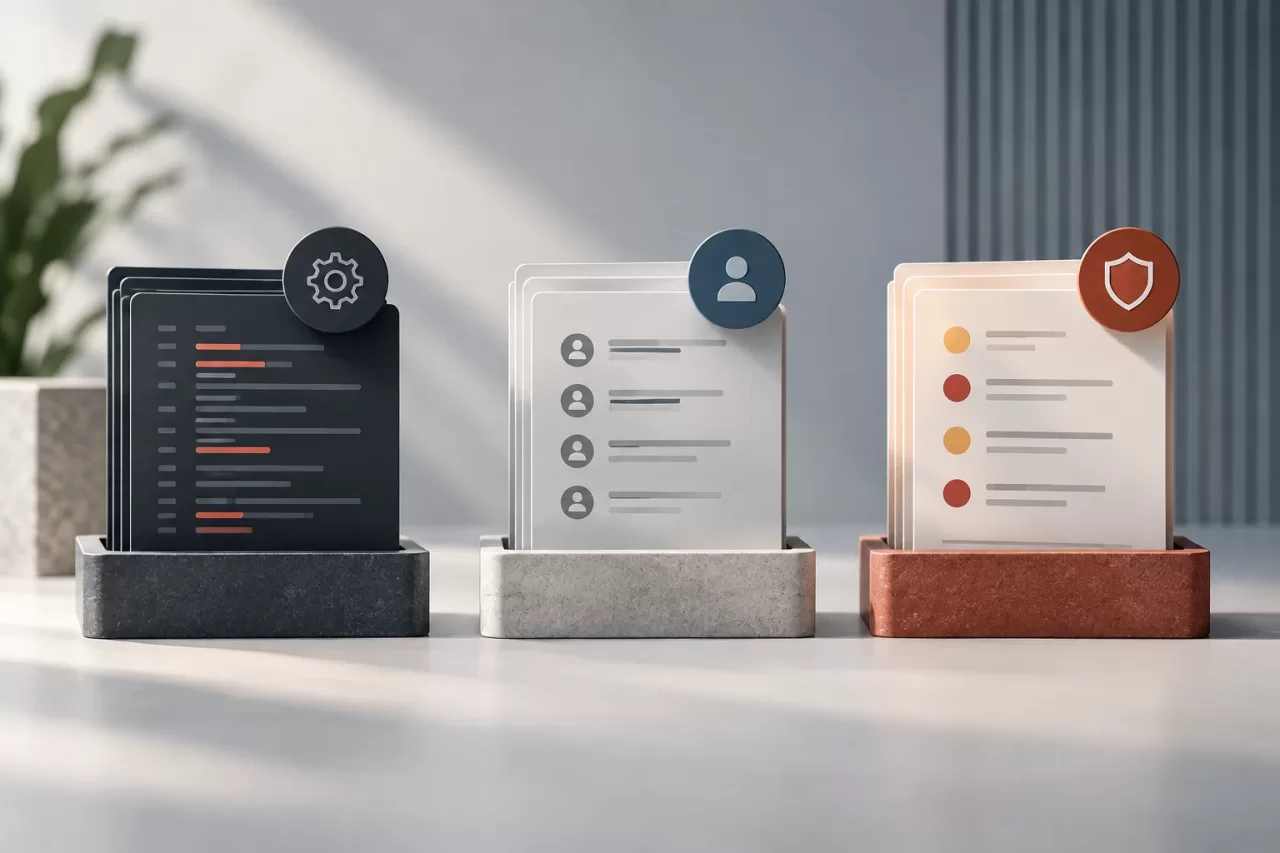
Les journaux techniques décrivent le fonctionnement de l’application : erreurs, exceptions, latence, échecs de connexion ou problèmes de configuration. Ils aident à diagnostiquer la disponibilité et le comportement. Le journal d’activité consigne les actions métier attribuables aux utilisateurs, comme la modification d’une facture ou des données d’un compte. Les événements de sécurité, quant à eux, portent sur les faits importants pour protéger les identités, les permissions, les ressources et les limites d’accès.
Il existe des recoupements, mais ces catégories ne sont pas interchangeables. Un changement de rôle peut être à la fois une activité métier et un événement de sécurité ; une exception de base de données est généralement technique, même si une série d’échecs lors d’une opération sensible peut justifier une alerte de sécurité. Définir les objectifs évite les doublons sans critères et permet d’attribuer des durées de conservation, des accès et des formats adaptés.
N’utilisez pas le journal de sécurité comme un référentiel d’audit illimité ni comme un substitut aux métriques et aux traces. Ne supposez pas non plus que consigner un événement revient à le détecter : générer des alertes nécessite des règles, des seuils et des responsables de la réponse. Documentez le système qui produit chaque donnée et l’équipe qui l’utilise.
Choisir les actions et le contexte nécessaires à l’enquête
Commencez par dresser l’inventaire des actions et des menaces importantes pour l’application. Parmi les événements à envisager figurent généralement les échecs de connexion, les verrouillages de compte, les changements d’identifiants, les attributions ou révocations de permissions, les changements de configuration, les exportations sensibles et les opérations d’administration. La liste doit refléter le produit : consigner chaque consultation d’une page peut générer du bruit, tandis qu’omettre une modification de privilèges empêche de reconstituer un accès indu.
Pour chaque événement, définissez la question à laquelle il doit permettre de répondre. En cas d’enquête sur un changement de permission, par exemple, il est important d’identifier l’acteur, l’utilisateur ou la ressource concernée, l’ancienne et la nouvelle permission, le résultat et le moment. Pour un échec d’authentification, l’identifiant de compte normalisé ou pseudonymisé selon la politique peut être pertinent, ainsi que le résultat et l’origine de la requête si leur collecte est justifiée. Évitez de déduire une identité à partir d’une adresse IP partagée.
Distinguez la tentative, la décision et le résultat. Une requête refusée n’est pas une modification menée à bien ; une requête acceptée peut échouer avant la persistance. Consignez le résultat réel et, si l’enquête le nécessite, l’étape atteinte. Définissez également la signification de chaque valeur, comme denied, failed ou succeeded, afin que les différents composants ne les utilisent pas de manière contradictoire.
Utiliser un schéma cohérent et corrélable
Un format structuré, généralement JSON, facilite le filtrage et la corrélation des événements dans les outils opérationnels. Voici les champs de base à envisager :
- Identifiant de l’événement : nom stable et versionné, par exemple
authorization.permission_changed. - Horodatage : date et heure en UTC, avec une précision adaptée et des horloges système synchronisées.
- Acteur : identifiant interne ou pseudonyme ; représentez explicitement les processus et les tâches automatisées.
- Action et ressource : opération effectuée, type et identifiant de la ressource concernée, sans inclure son contenu.
- Résultat : réussite, refus ou échec, avec un motif catégorisé et non sensible.
- Corrélation : identifiant de requête ou d’opération permettant de relier les événements sans enregistrer la requête dans son intégralité.
- Contexte de l’origine : service ou composant ayant émis l’événement et, si cela est justifié, données limitées sur l’origine réseau.
Les noms et les types des champs doivent rester stables. Un identifiant de corrélation de requête doit être généré ou validé par l’infrastructure ; accepter sans contrôle un identifiant arbitraire peut provoquer des collisions ou de la confusion. N’incluez pas tous les en-têtes, les corps HTTP ni les paramètres sans discernement. Le contexte doit aider à reconstituer la séquence, et non reproduire toutes les données traitées.
Exclure les secrets et minimiser les données personnelles
Ne consignez jamais de mots de passe, de jetons d’accès, de clés API, de secrets de session, de codes de récupération ni de valeurs permettant de s’authentifier. Évitez également les données personnelles complètes lorsqu’un identifiant interne suffit. Pour des champs comme l’adresse e-mail, le numéro de téléphone ou l’adresse postale, déterminez s’il est indispensable de les conserver, s’ils peuvent être masqués ou s’il vaut mieux utiliser une référence pseudonymisée. La décision dépend de l’objectif, du risque et des obligations applicables.
La rédaction doit avoir lieu avant que l’événement ne quitte le processus ; ne vous fiez pas uniquement à un filtre ultérieur de l’agrégateur. En PHP, évitez de sérialiser directement des objets de requête, des en-têtes ou des exceptions susceptibles de contenir des valeurs sensibles. Créez un objet ou un tableau explicite comportant une liste de champs autorisés ; une stratégie de liste d’exclusion est fragile lorsque de nouveaux champs apparaissent. Validez et limitez également la longueur des valeurs contrôlables par l’utilisateur afin de réduire les injections de lignes, le bruit et la consommation excessive.
Testez les cas où des données secrètes figurent dans des paramètres ou des messages d’erreur et vérifiez qu’elles n’atteignent pas la destination des journaux. La sanitisation doit conserver suffisamment d’informations pour permettre une enquête, par exemple une catégorie d’erreur, sans conserver le message complet s’il risque d’inclure des identifiants.
Protéger l’accès, l’intégrité et le cycle de vie
Les journaux contiennent eux aussi des informations sensibles. Limitez les personnes autorisées à écrire, lire, exporter et gérer la durée de conservation ; ces fonctions peuvent nécessiter des permissions distinctes. Protégez le transport et le stockage avec les contrôles adaptés à l’infrastructure, et évitez qu’un compte applicatif compromis puisse effacer ou modifier tout l’historique sans laisser de trace. Lorsque le risque le justifie, utilisez un stockage append-only ou des contrôles d’intégrité vérifiables, et documentez leurs limites.
Définissez une durée de conservation explicite pour chaque catégorie d’événement. Une conservation indéfinie augmente l’exposition et les coûts ; une suppression trop rapide peut compromettre une enquête. La politique doit tenir compte des copies, des exportations, des environnements de test et des demandes de suppression concernant des données personnelles. Consignez et examinez les accès des opérateurs aux journaux eux-mêmes, en particulier les exportations et les changements de politique.
Le logging peut échouer si la destination est indisponible, si la capacité de stockage est atteinte ou si la sérialisation échoue. Décidez de la conduite à tenir dans chaque cas selon la criticité. Ne laissez pas une panne du système de journalisation permettre de mener silencieusement à terme une opération à haut risque, mais ne laissez pas non plus une exception de journalisation provoquer des résultats incohérents ou dupliquer une transaction. Pour les opérations critiques, il peut être nécessaire d’assurer l’écriture de l’événement en même temps que la modification à l’aide d’une stratégie transactionnelle, comme le modèle outbox. Si une file d’attente est utilisée, définissez les nouvelles tentatives, la déduplication et le traitement des événements en attente.
Vérifier que l’événement existe et qu’il est sûr
Les tests doivent vérifier davantage que l’appel à une fonction de journalisation. Parcourez des scénarios représentatifs : accès refusé, privilège accordé, privilège révoqué et changement sensible mené à bien ou en échec. Vérifiez que l’événement contient l’acteur, la ressource, le résultat, l’horodatage et la corrélation ; que le résultat correspond à ce qui s’est réellement produit ; et qu’aucun mot de passe, jeton ou donnée superflue n’apparaît.
Incluez des tests portant sur les défaillances de la destination des journaux et vérifiez si l’opération principale reste dans un état cohérent, si un signal de remplacement est généré et si l’erreur est visible pour les équipes d’exploitation. Pour une action sensible, confirmez qu’aucune réussite n’est signalée si la modification n’a pas été persistée. Testez également les limites et les entrées manipulées, comme les sauts de ligne dans les valeurs contrôlables, ainsi que les droits de lecture par rôle : un utilisateur métier ne devrait pas avoir accès par défaut au dépôt d’événements.
Liste de contrôle pour examiner une implémentation
- Chaque événement a-t-il un objectif, un responsable et une politique de conservation définis ?
- Les tentatives, les refus, les échecs et les opérations terminées sont-ils distingués ?
- Le schéma permet-il d’identifier l’acteur, l’action, la ressource, le résultat et l’horodatage ?
- Une corrélation avec la requête est-elle possible sans en consigner tout le contenu ?
- Les secrets sont-ils exclus et les données personnelles minimisées avant l’envoi ?
- L’accès, le transport, le stockage et la suppression sont-ils contrôlés ?
- L’indisponibilité de la destination, l’intégrité de l’opération et les permissions de lecture ont-elles été testées ?
Commencez par prioriser les événements qui protègent les comptes, les privilèges et les opérations ayant le plus grand impact. Standardisez ensuite le schéma, limitez les données et automatisez des tests qui échouent si un secret se retrouve dans les journaux. Le logging de sécurité en PHP fournit ainsi des éléments exploitables sans devenir une seconde base de données contenant des informations sensibles.