Um backup bem-sucedido, por si só, não demonstra que uma aplicação pode voltar a prestar serviço. Pode faltar uma chave, uma dependência externa, os arquivos que acompanham o banco de dados ou um procedimento que indique em que ordem recuperá-los. Os testes de recuperação de desastres em aplicações PHP permitem verificar o processo completo antes que uma perda ou corrupção de dados obrigue a executá-lo sob pressão.
O objetivo não é garantir que nunca haverá interrupções, mas obter evidências sobre o que pode ser recuperado, quanto tempo isso leva e quais obstáculos ainda precisam ser resolvidos. Para que o exercício seja útil, é preciso definir seu escopo, isolar o ambiente, validar tanto a infraestrutura quanto o comportamento da aplicação e atribuir responsáveis pelas melhorias necessárias.
Verificar um backup não é recuperar o serviço
Uma verificação de backup pode confirmar que um arquivo existe, que seu tamanho parece razoável ou que uma ferramenta consegue lê-lo. É um controle valioso, mas diferente de restaurar os componentes necessários e demonstrar que a aplicação funciona com eles.
A recuperação completa pode incluir um banco de dados, arquivos enviados por usuários, código e configuração, além de serviços como filas de trabalho, armazenamento de objetos, cache ou tarefas agendadas. Também pode depender de DNS, certificados, permissões, extensões do PHP e serviços externos. Se um desses elementos estiver ausente ou não for compatível com os demais, o backup pode ser válido e, ainda assim, o serviço não estar recuperado.
Convém definir o que significa «recuperado» para cada aplicação. Isso pode implicar que o processo PHP inicialize, que usuários autorizados consigam fazer login e concluir um fluxo crítico ou que os trabalhos em segundo plano voltem a ser processados. Uma página inicial visível não basta como único critério.
Definir o escopo e os critérios de sucesso antes de começar
Documente o cenário que será testado: por exemplo, perda de um banco de dados, corrupção de arquivos ou indisponibilidade de um ambiente completo. Não é necessário simular todos os incidentes em uma única sessão. Delimitar o cenário permite identificar quais componentes devem ser restaurados e o que fica expressamente fora do exercício.
Defina critérios verificáveis com as áreas de negócio, tecnologia e operações. Entre as perguntas práticas estão:
- Quais funções devem voltar a estar disponíveis e quais podem esperar?
- Até que momento seria aceitável recuperar os dados e que perda de alterações seria tolerável?
- Por quanto tempo o serviço pode ficar interrompido antes que o impacto seja inaceitável?
- Quais dependências fazem parte da recuperação e quais serão representadas por substitutos seguros?
- Quem autoriza a execução, valida o resultado e comunica os problemas?
Os objetivos de ponto de recuperação (RPO) e de tempo de recuperação (RTO) podem ajudar a expressar as tolerâncias de perda de dados e de interrupção. Eles devem ser definidos de acordo com as necessidades e capacidades de cada serviço; não existe um valor universal. O teste permite comparar os tempos e o estado dos dados observados com esses objetivos, sem transformar um resultado isolado em uma garantia futura.
Preparar um ambiente isolado e seguro
Faça a restauração em um ambiente separado da produção, com controles para impedir que o exercício altere dados reais ou envie mensagens a clientes. Isole as redes quando possível e bloqueie ou substitua integrações que possam executar cobranças, enviar e-mails, publicar eventos ou modificar sistemas externos. Informe aos participantes que se trata de um teste.
Os dados restaurados podem conter informações sensíveis. Aplique as políticas correspondentes de acesso, retenção e proteção de dados; limite quem pode acessar o ambiente e por quanto tempo. Evite reutilizar credenciais de produção. Gerencie os segredos de teste de forma controlada e verifique se os arquivos restaurados não os expõem em logs, repositórios ou diretórios acessíveis publicamente.
Registre as condições iniciais: data e ponto do backup, versões de código e configuração necessárias, recursos disponíveis e diferenças entre o ambiente de teste e o de produção. Uma versão diferente do PHP, extensões ausentes ou permissões diferentes podem afetar o resultado. Essas divergências devem ser registradas, e não confundidas com um sucesso ou uma falha do backup.
Executar a recuperação de todos os componentes necessários
Siga o procedimento documentado, mesmo que conheça uma forma mais rápida. O objetivo é justamente verificar se as instruções são suficientes para que outra pessoa consiga recuperar o serviço. Anote a ordem e a duração de cada etapa, os comandos manuais, as decisões tomadas e qualquer intervenção que não estivesse prevista.
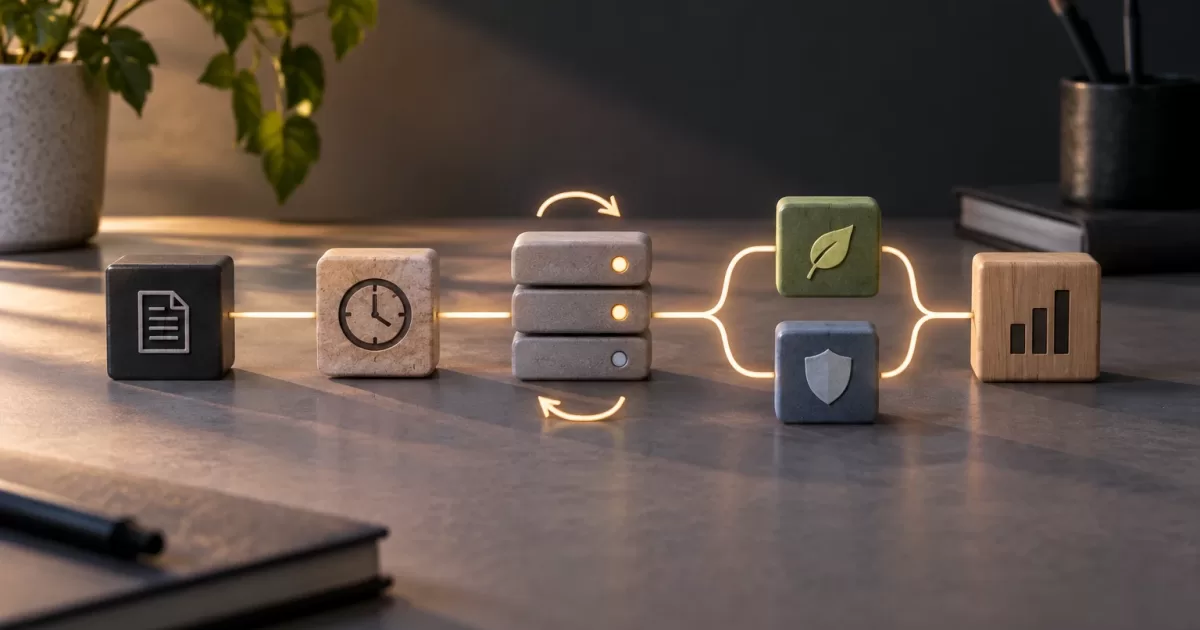
Uma sequência possível, que deve ser adaptada a cada arquitetura, é restaurar a infraestrutura e a configuração, recuperar o banco de dados e os arquivos, fazer o deploy da versão de código compatível e conectar as dependências necessárias. No PHP, verifique, conforme aplicável, a configuração do servidor web e do PHP-FPM, as extensões necessárias, as variáveis de ambiente, as permissões de escrita e as tarefas agendadas. Verifique também as filas, o armazenamento de objetos e os processos workers, se a aplicação depender deles.
Não execute migrações nem processos de reconstrução de dados automaticamente sem conhecer seu efeito em um backup restaurado. Verifique se as credenciais apontam exclusivamente para serviços de teste e se as tarefas do cron não produzem efeitos externos. Se a recuperação exigir intervenção manual, registre-a como parte do tempo real e como um possível ponto de melhoria.
Validar a integridade e o comportamento, não apenas a inicialização
As verificações devem abranger dados e fluxos funcionais. Comece pelas verificações técnicas: conectividade com o banco de dados, estado dos processos, espaço disponível, logs de erro e resposta dos serviços internos. Depois, valide se os arquivos armazenados e suas referências estão de acordo e se as relações ou restrições importantes do banco de dados continuam coerentes.
Escolha consultas e fluxos representativos, compatíveis com o uso real da aplicação. Por exemplo, verifique se é possível localizar uma entidade conhecida, fazer login com uma conta de teste e concluir uma operação sem efeitos externos. Se houver arquivos enviados, valide se podem ser recuperados e associados aos respectivos registros. Se existirem filas, verifique se os trabalhos pendentes têm o comportamento esperado e não são processados duas vezes por engano.
Guarde evidências suficientes para repetir a avaliação: resultados de consultas, etapas realizadas, erros observados e horários de início e fim. Não basta registrar «funciona». Defina antecipadamente quais verificações aprovam o exercício e quais são impeditivas. Uma aplicação que responde, mas apresenta dados incompletos ou não processa operações críticas, não deve ser considerada recuperada segundo critérios mais exigentes.
Medir, corrigir e repetir com uma frequência útil

Meça o tempo desde o início acordado até o cumprimento dos critérios de recuperação, e não apenas o tempo de restauração de um banco de dados. Se isso ajudar na análise, separe a espera, o trabalho automático, as etapas manuais e a validação. Compare o resultado com os objetivos acordados e identifique premissas que não se confirmaram, como permissões indisponíveis ou documentação desatualizada.
O relatório deve incluir escopo, ponto restaurado, resultado de cada verificação, tempos observados, incidentes, decisões e responsáveis pelas ações corretivas. Priorize medidas que reduzam impedimentos: automatizar etapas repetíveis, atualizar instruções, corrigir permissões, revisar dependências ou melhorar a estratégia de backups. Defina datas de acompanhamento e repita a parte afetada para verificar se a correção resolveu o problema.
A frequência depende do risco, das mudanças na arquitetura e da capacidade operacional. É possível combinar uma restauração parcial frequente — por exemplo, de um banco de dados ou de arquivos — com exercícios de recuperação completa e cenários distintos. Também convém repetir o teste após mudanças relevantes no sistema de backups, na infraestrutura ou nas dependências. Um teste bem-sucedido fornece evidências sobre um cenário e condições específicos: não garante o resultado de todos os incidentes futuros.