La decisione tra MySQL e PostgreSQL non dovrebbe partire da quale dei due conosce meglio una persona del team né da una query spettacolare vista in una dimostrazione. Deve partire dalle operazioni che l'applicazione dovrà sostenere in modo affidabile: registrare ordini, riservare disponibilità, ricalcolare saldi, accettare modifiche simultanee, generare report o integrare dati esterni.
Entrambi i motori sono opzioni mature per un'applicazione PHP transazionale. La differenza rilevante emerge quando si definiscono il modello dati, il comportamento in condizioni di concorrenza, le garanzie di integrità e il carico operativo che l'organizzazione può sostenere. Scegliere bene non elimina il lavoro di progettazione; riduce le incompatibilità tra le regole di business e la piattaforma dati.
Il punto di partenza sono le operazioni critiche
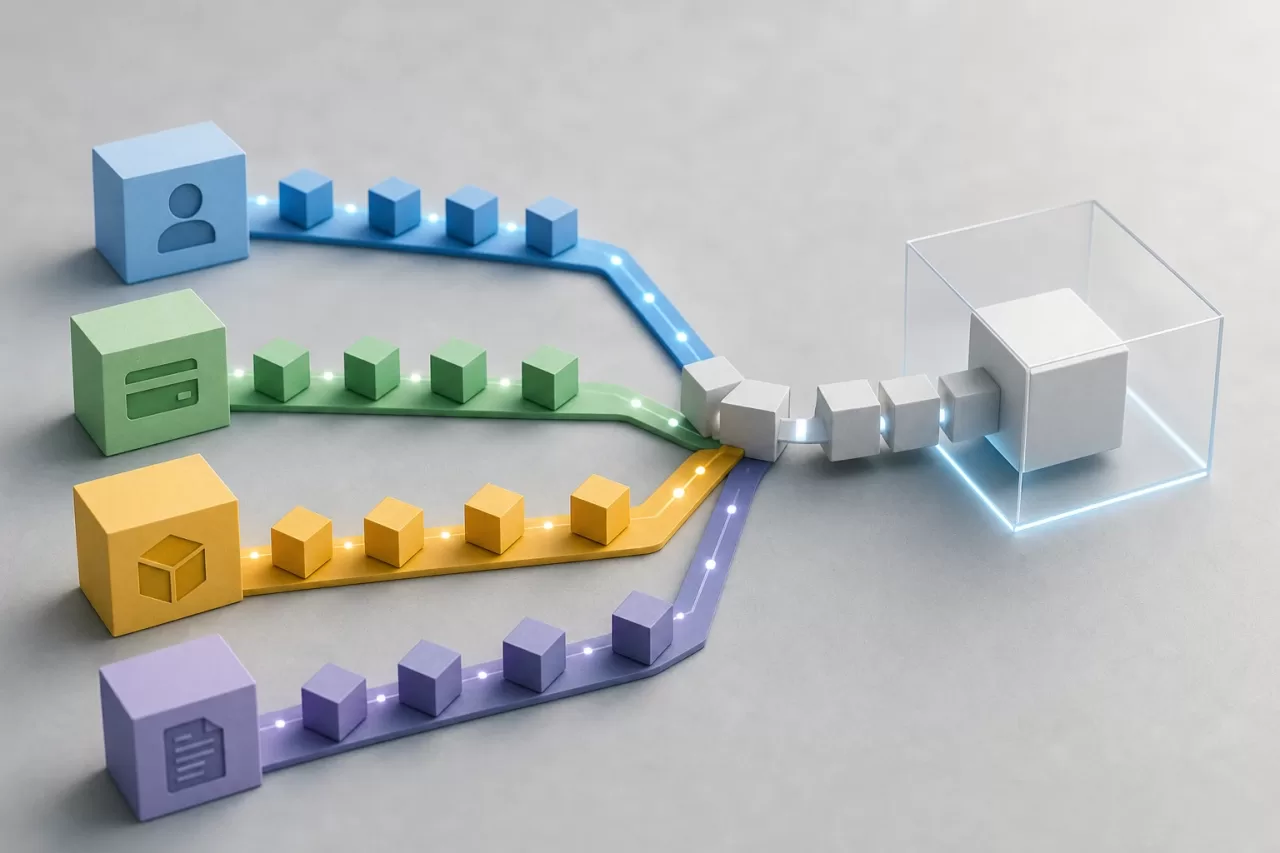
Prima di confrontare le caratteristiche, descriva i flussi che non possono perdere dati, duplicare effetti né lasciare stati incoerenti. La creazione di un utente è diversa dalla conferma di un pagamento, dalla prenotazione di un'unità di inventario o dal consolidamento di una fattura. Ogni operazione ha requisiti di atomicità, ordine, latenza e tracciabilità.
Trasformi i casi d'uso in un elenco verificabile. Per ciascuno, annoti quali dati legge, quali record scrive, quale regola deve essere rispettata, quanti utenti o processi possono eseguirlo contemporaneamente e cosa accade se viene interrotto. Questo inventario evita di decidere in base a una preferenza tecnologica quando il problema è in realtà un modello degli stati mal definito.
- Operazioni di business: creazioni, annullamenti, cambi di stato, addebiti, rimborsi e prenotazioni.
- Processi asincroni: importazioni, retry, code, ricalcoli e notifiche.
- Letture operative: elenchi filtrati, schede, autorizzazioni e ricerche frequenti.
- Letture analitiche: aggregazioni, confronti temporali, esportazioni e report.
- Integrazioni: API, webhook, sistemi contabili e fonti di dati esterne.
Nel definire come scegliere MySQL o PostgreSQL per un'applicazione PHP, la domanda utile è: quali errori deve impedire il sistema anche se l'applicazione presenta un malfunzionamento, ci sono due richieste simultanee o un processo viene ritentato?
Inventario di dati, regole e incertezze
Modelli le entità, le relazioni e i cicli di vita prima di selezionare il motore. Identifichi chiavi primarie, relazioni obbligatorie, unicità, importi, date, stati e documenti semistrutturati. Separi inoltre i dati operativi da quelli che servono soltanto per audit, ricerca o analisi.
I vincoli del database sono una seconda linea di difesa, non un sostituto delle validazioni PHP. L'applicazione deve fornire messaggi comprensibili e validare l'input; il database deve rafforzare invarianti che non possono essere violati. Per esempio, una chiave esterna può impedire riferimenti inesistenti, un vincolo di unicità può evitare la duplicazione di un identificatore esterno e un vincolo CHECK può limitare i valori consentiti.
PostgreSQL risulta spesso particolarmente comodo quando il dominio richiede tipi ricchi, controlli espressivi, query analitiche complesse o una combinazione deliberata di struttura relazionale e documenti JSON. Anche MySQL è una scelta solida per molti prodotti di business con schemi relazionali, transazioni e pattern di query convenzionali. La decisione non deve trasformare queste tendenze in regole assolute: validi le query e le regole effettive.
Dati flessibili senza perdere il contratto
Memorizzare attributi variabili in JSON può accelerare una prima integrazione, ma non elimina la necessità di definire quali campi esistono, come vengono validati e come vengono interrogati. Se un attributo interviene in autorizzazioni, prezzi, disponibilità o report ricorrenti, normalmente merita una struttura esplicita e indici adeguati. I documenti semistrutturati funzionano meglio per dati variabili con un contratto noto che per nascondere un modello che nessuno ha deciso.
Valuti scrittura, transazioni e concorrenza
La scrittura concorrente è il punto in cui emergono molte decisioni architetturali. Non basta sapere che entrambi i motori supportano le transazioni: bisogna testare quali righe vengono aggiornate, quanto dura ogni transazione, quali indici partecipano e come vengono gestiti i conflitti.
Una prenotazione di inventario, per esempio, deve evitare che due richieste confermino l'ultima unità. La soluzione può richiedere un aggiornamento condizionale, un lock deliberato o un controllo di versione ottimistico, a seconda del flusso. Non è opportuno aprire una transazione, chiamare un servizio remoto e mantenere lock mentre arriva la risposta. Limiti la transazione alle operazioni sui dati necessarie e progetti compensazioni o retry per gli errori esterni.
- Misuri le creazioni simultanee sulle stesse entità o risorse scarse.
- Definisca quali operazioni possono essere ritentate senza duplicare effetti mediante chiavi di idempotenza.
- Esamini i piani di esecuzione e gli indici degli aggiornamenti, non soltanto quelli degli elenchi.
- Registri tempi di attesa, lock, errori di transazione e query lente.
- Testi con volumi e concorrenza rappresentativi, non soltanto con un database vuoto.
In PHP, utilizzi un livello di accesso che renda espliciti i confini transazionali. PDO, un ORM o un query builder possono facilitare il lavoro, ma non decidono da soli l'isolamento, l'ordine di aggiornamento né la strategia di retry. Anche una migration deve riflettere vincoli, indici e modifiche ai dati associate, non limitarsi a creare colonne.
Distingua le letture operative dai report
Una schermata operativa richiede di solito risposte prevedibili con filtri concreti, ordinamento e paginazione. Un report può attraversare periodi estesi, unire molte entità e calcolare aggregati. Mescolare entrambi i pattern senza progettazione fa sì che un'esportazione pesante competa con l'attività quotidiana.
Parta dalle query che verranno eseguite frequentemente e da quelle che possono degradare il servizio. Definisca filtri, cardinalità prevista, ordinamento, paginazione e necessità di consistenza. Crei indici per pattern osservabili, verificando che non penalizzino in modo inaccettabile le scritture. Un indice non è un miglioramento astratto: consuma spazio, aggiunge lavoro durante l'inserimento e l'aggiornamento e deve giustificare una query concreta.
PostgreSQL offre un ampio insieme di strumenti per query complesse, aggregazioni, funzioni finestra ed estensibilità. MySQL può risolvere efficacemente molte query relazionali ben indicizzate ed è un'opzione ragionevole quando i pattern sono chiari. Se l'esigenza principale è la ricerca testuale avanzata, l'analisi massiva o il reporting su larga scala, valuti anche componenti specializzati. Non costringa il database transazionale ad assumere una funzione diversa senza definire sincronizzazione, consistenza e recupero in caso di ritardi.
Operatività: il criterio che non deve restare alla fine
La migliore scelta tecnica fallisce se non può essere ripristinata, aggiornata né diagnosticata. Documenti chi amministrerà il motore, come verranno applicate le patch, quale ambiente riproduce gli incidenti e quale procedura consente di recuperare un servizio dopo un errore umano, una migration fallita o una perdita dell'infrastruttura.
I backup non sono sufficienti se i ripristini non vengono mai testati. Stabilisca obiettivi di recupero coerenti con l'impatto del prodotto e verifichi periodicamente che un backup consenta di ricostruire il database, applicare i log necessari se esistono e avviare l'applicazione con dati consistenti. Protegga backup e credenziali, limiti i privilegi, cifri le comunicazioni quando opportuno e mantenga l'audit degli accessi amministrativi.
Il monitoraggio deve collegare i sintomi tecnici all'impatto: saturazione delle connessioni, crescita dello storage, query lente, lock, replica in ritardo, errori di autenticazione e durata delle attività di manutenzione. Il team deve saper interpretare questi segnali e disporre di procedure chiare. Una tecnologia che nessuno sa gestire con sicurezza ha un costo nascosto maggiore di una differenza marginale di prestazioni.
Alternative che aumentano il rischio
Scegliere un motore per una sola query, per una scalabilità futura senza evidenze o perché un'altra azienda lo utilizza tende a rimandare la decisione reale. È inoltre rischioso installare MySQL e PostgreSQL nello stesso prodotto senza un confine di responsabilità. Due motori implicano due catene di backup, aggiornamenti, avvisi, permessi, migration e conoscenza operativa.
Utilizzi entrambi soltanto se esiste una ragione delimitata e sostenibile: per esempio, una piattaforma legacy che deve convivere temporaneamente con un nuovo servizio, o una responsabilità dei dati separata con interfacce chiare. Definisca la proprietà di ciascun dato, la fonte di verità, la sincronizzazione, il trattamento dei guasti e il piano di dismissione. Replicare dati tra motori senza queste regole introduce divergenze difficili da spiegare.
Matrice pratica per prendere e rivedere la decisione
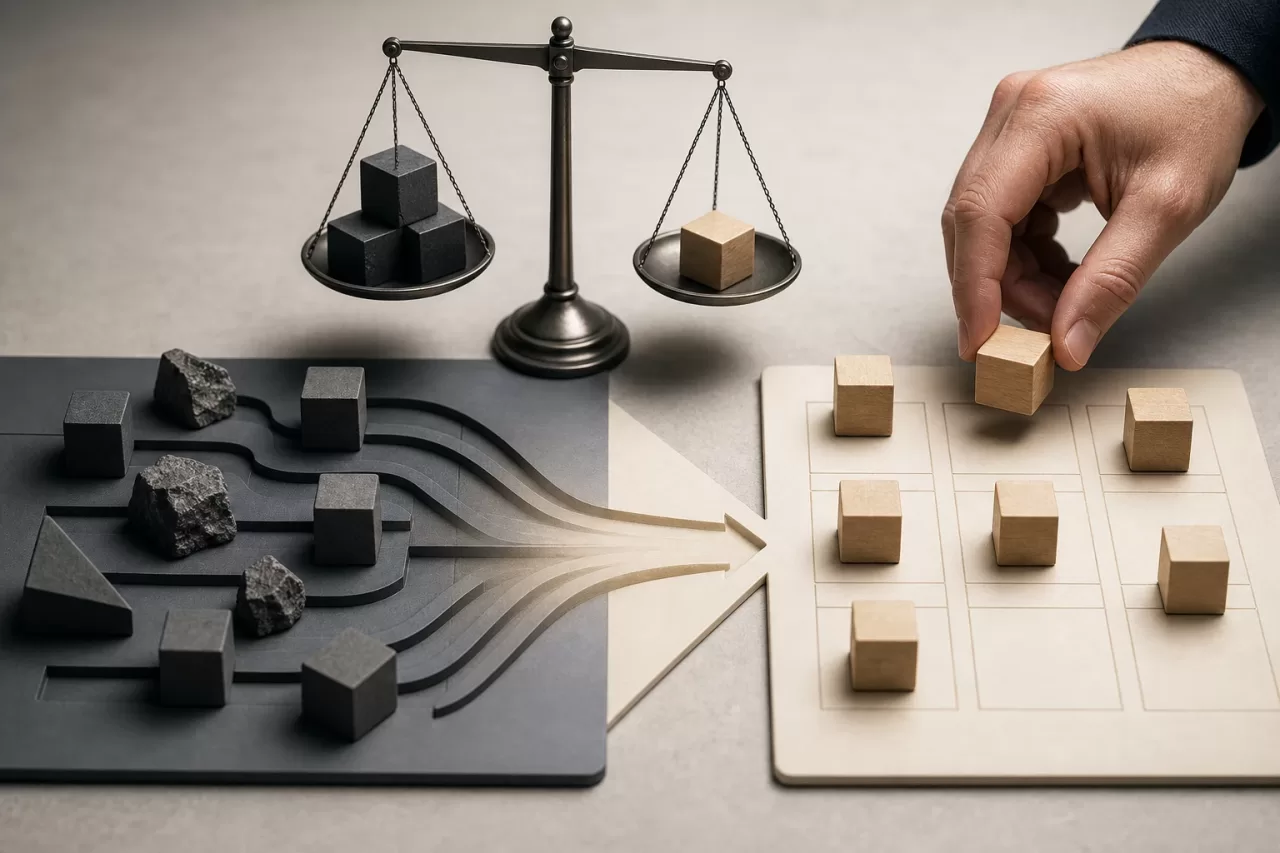
Attribuisca un punteggio a ciascuna opzione con evidenze del sistema attuale e dei rischi imminenti, non con preferenze. Assegni un peso maggiore ai flussi la cui corruzione o indisponibilità comporti conseguenze rilevanti. Il punteggio non sostituisce la revisione tecnica, ma obbliga a rendere visibili le ipotesi.
- Elenci da cinque a dieci operazioni critiche e il relativo livello di concorrenza.
- Valuti la complessità di query, report, tipi di dati ed esigenze di ricerca.
- Indichi le regole di integrità che devono essere rafforzate al di fuori dell'applicazione.
- Valuti le effettive capacità operative, di ripristino, monitoraggio e supporto interno.
- Realizzi una breve prova con query, dati e conflitti rappresentativi.
- Stimi il costo del cambiamento successivo: migrazione, indisponibilità, validazione e formazione.
- Documenti la decisione, i limiti accettati e i segnali che obbligherebbero a rivederla.
La scelta appropriata è quella che consente di mantenere le operazioni critiche con regole chiare, prestazioni verificabili e un'operatività che il team può sostenere.
MySQL o PostgreSQL non sono un'identità architetturale. Sono componenti che devono adattarsi al modello di business, al codice PHP, alle pratiche di delivery e alla responsabilità operativa. Decidere sulla base di flussi concreti consente di iniziare con una base ragionata e di mantenere criteri oggettivi per evolverla.