Ein Canary Deployment in PHP ermöglicht es, eine neue Version einem kontrollierten Teil des Traffics auszusetzen und ihr Verhalten zu bewerten, bevor der Anteil erhöht wird. Sein Wert besteht weder darin, Tests zu ersetzen, noch darin, die Sicherheit einer Änderung zu garantieren: Es bietet eine Möglichkeit, Probleme in der Produktion zunächst mit begrenzter Reichweite und anhand expliziter Entscheidungskriterien zu erkennen.
Damit es funktioniert, müssen die Versionen parallel betrieben werden können, der Traffic muss sich kontrolliert lenken lassen und das Team muss vergleichbare Ergebnisse beobachten können. Lässt die Infrastruktur diese Voraussetzungen nicht zu, kann eine einfachere schrittweise Veröffentlichung oder ein gut geplantes Wartungsfenster die sinnvollere Wahl sein.
Welches Risiko ein Canary Deployment kontrolliert
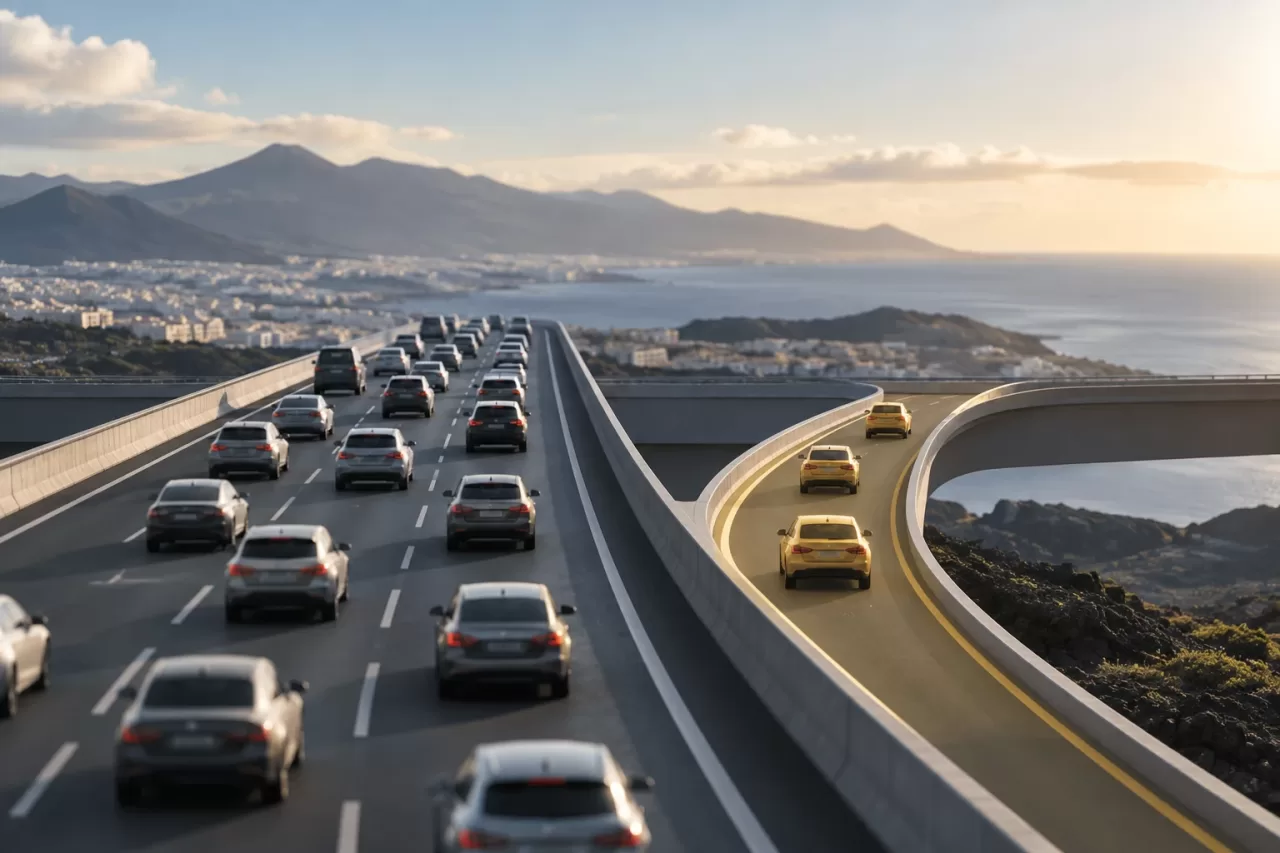
Automatisierte Tests und Staging-Umgebungen helfen dabei, Fehler zu finden, bilden aber nicht zwangsläufig die tatsächliche Verteilung von Kunden, Daten, Integrationen und Last ab. Bei einem Canary wird eine Version mit echten Anfragen getestet, wobei vorab begrenzt wird, welcher Teil der Nutzer betroffen sein kann.
In der Praxis erhält die Kandidatenversion einen Teil des Traffics, während die stabile Version den Rest weiterhin bedient. Das Team vergleicht die Health-Metriken beider Versionen. Gibt es keine relevanten Regressionen, wird der Anteil erhöht; zeigen sich negative Signale, stoppt das Team die Ausweitung und wendet das vorgesehene Verfahren an.
Ein Canary unterscheidet sich von einem progressiven Deployment, das lediglich bedeutet, eine Veröffentlichung in mehreren Phasen durchzuführen. Bei einem Canary stehen die Bewertung einer Nutzergruppe und der Vergleich von Signalen vor der Entscheidung im Mittelpunkt. Davon zu unterscheiden ist auch die schrittweise Aktivierung über einen Feature Flag: Damit lässt sich eine neue Funktion verbergen, obwohl der Code bereits bereitgestellt ist; ein Vergleich zweier Anwendungsversionen ist damit aber nicht zwangsläufig möglich.
Wann es sich eignet und wann eine einfachere Lösung sinnvoller ist
Ein Canary kann sich lohnen, wenn eine Änderung erhebliche Auswirkungen haben kann, die Anwendung ausreichend Traffic erhält, um aussagekräftige Signale zu beobachten, und die Architektur den parallelen Betrieb zweier Versionen ermöglicht. Besonders nützlich ist er, wenn sich die betroffene Nutzergruppe eingrenzen und jede Anfrage der Version zuordnen lässt, die sie bearbeitet hat.
Er ist nicht immer den Aufwand wert. Bei geringem Traffic können die Ergebnisse nicht aussagekräftig sein; ist der Dienst klein und die Änderung von begrenzter Tragweite, können die Betriebskosten für Traffic-Routing und Observability den Nutzen übersteigen. Ein Canary sollte auch nicht als ausreichender Schutz vor einer inkompatiblen Migration oder einem irreversiblen Vorgang dargestellt werden.
Einfachere Alternativen sind eine Veröffentlichung in einem Wartungsfenster mit geringerer Aktivität, ein Feature Flag zur Steuerung einer bestimmten Funktion oder ein erstes Deployment in einer internen Umgebung. Diese Optionen lösen unterschiedliche Probleme: Ein Wartungsfenster mit geringerer Aktivität verkürzt den Zeitraum, in dem die Änderung produktiv exponiert ist; ein Flag steuert die Aktivierung und eine interne Umgebung ermöglicht eine vorherige Validierung. Die Entscheidung hängt davon ab, welches Risiko reduziert werden soll und welche Möglichkeiten verfügbar sind.
Anforderungen an Infrastruktur und Betrieb
Prüfen Sie vor der Automatisierung eines Canary Deployments in PHP, ob die Infrastruktur die stabile Version und die Kandidatenversion parallel betreiben kann. Dafür können separate Deployment-Artefakte, kompatible PHP-Prozesse und Konfigurationen sowie ausreichende Kapazitäten für den Betrieb beider Versionen während der Evaluierung erforderlich sein.
- Kontrolliertes Routing: Ein Load Balancer, Proxy, eine Containerplattform oder eine andere Komponente muss einen definierten Anteil des Traffics oder eine bestimmte Nutzergruppe an die Kandidatenversion senden können. Der Mechanismus muss reversibel sein und eine betriebliche Zuständigkeit haben.
- Versionskennzeichnung: Logs, Metriken und Traces müssen erkennen lassen, welche Version die jeweilige Anfrage bearbeitet hat. Ohne diese Trennung kann ein Vergleich die Auswirkungen beider Versionen vermischen.
- Kompatible Konfiguration: Secrets, Umgebungsvariablen, Sessions, Caches und gemeinsam genutzte Queues müssen während des parallelen Betriebs funktionieren. Inkompatible Formate oder Schnittstellen zwischen Versionen dürfen nicht vorausgesetzt werden.
- Handlungsrelevante Observability: Legen Sie Dashboards und Alerts vor der Veröffentlichung fest. Eine Metrik, die niemand rechtzeitig abrufen oder interpretieren kann, hilft nicht bei der Entscheidungsfindung.
Berücksichtigen Sie auch die Persistenz von Sessions und die Traffic-Affinität. Einen Nutzer stets derselben Version zuzuordnen, kann den Vergleich erleichtern, hängt aber von der Architektur ab und kann die Ergebnisse verzerren. In jedem Fall muss das Routing unerwartete Zustandswechsel zwischen Versionen verhindern.
Nutzergruppen, Phasen und Bewertungssignale festlegen
Beginnen Sie mit einer Nutzergruppe, deren Exposition Sie erklären und begrenzen können. Sie kann anhand eines Anteils der Anfragen oder eines kontrollierten Segments definiert werden, sofern die Auswahl konsistent ist und nicht gerade wichtige Anwendungsfälle ausschließt. Gehen Sie nicht davon aus, dass ein bestimmter Prozentsatz für jeden Dienst sicher ist: Die anfängliche Größe hängt vom Volumen, den potenziellen Auswirkungen und der Reaktionsfähigkeit ab.
Legen Sie die Phasen der Ausweitung und die Beobachtungsdauer im Voraus fest. Jede Phase muss lang genug sein, um die relevante Nutzung zu beobachten. Es reicht nicht, ein beliebiges Intervall abzuwarten, wenn der betroffene Ablauf selten vorkommt. Bestimmen Sie, wer die Daten prüft und wer den Prozess stoppen darf.
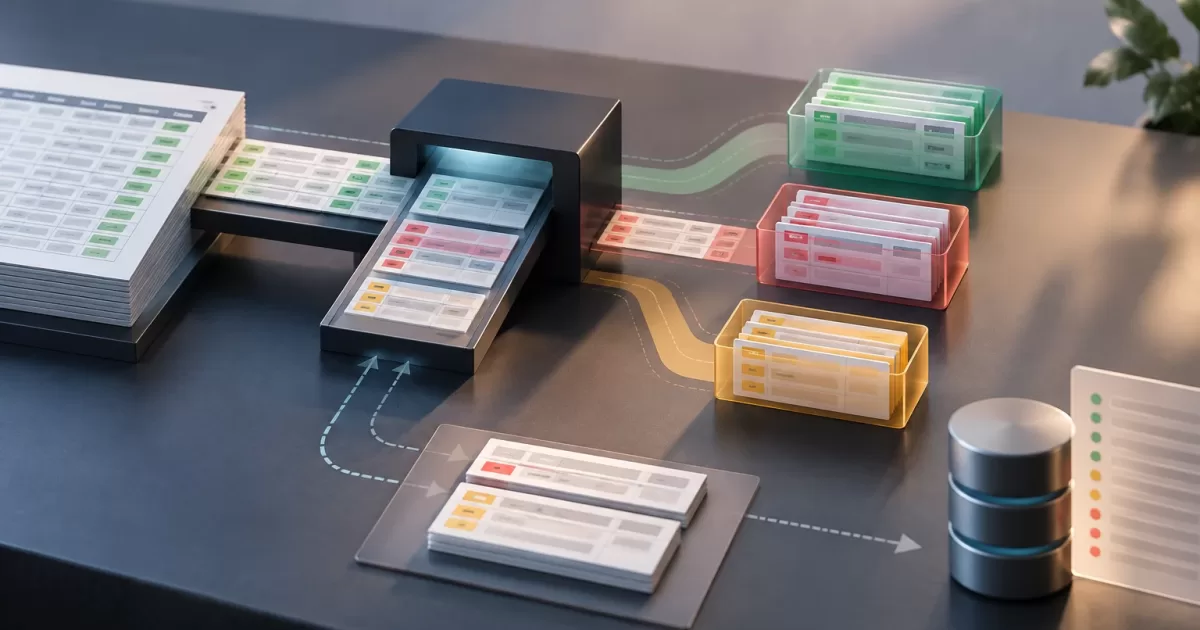
Vergleichen Sie die Kandidatenversion und die stabile Version anhand von Signalen, mit denen sich sowohl technische Fehler als auch Nachteile für Nutzer erkennen lassen:
- Fehler: Raten fehlgeschlagener Antworten, PHP-Ausnahmen, Fehler von Abhängigkeiten und Ausfälle asynchroner Prozesse, jeweils der betreffenden Version zugeordnet.
- Latenz: Antwortzeiten, idealerweise aufgeschlüsselt nach wichtigen Routen oder Transaktionen, zusammen mit Signalen zur Ressourcenauslastung.
- Geschäftsergebnisse: Abschluss eines Vorgangs, verarbeitete Zahlungen oder Fehler in einem relevanten Ablauf – stets auf Grundlage verlässlicher Definitionen und Datenquellen.
- Integrität: Duplikate, inkonsistente Zustände oder Abweichungen zwischen Systemen, sofern sich die Änderung auf Daten oder Prozesse auswirken kann.
Eine Verbesserung oder Stabilität bei einer aggregierten Metrik schließt ein Problem nicht aus, das sich auf eine Route, einen Kunden oder eine Abhängigkeit konzentriert. Prüfen Sie den Kontext und die Verteilung der Fehler und vergleichen Sie nach Möglichkeit gleichwertige Zeiträume und Nutzergruppen.
Schwellenwerte festlegen und einen Rollback vorbereiten
Vereinbaren Sie vor dem Deployment, unter welchen Bedingungen die Ausweitung zulässig ist, wann pausiert werden muss und wann ein Rollback erforderlich ist. Die Schwellenwerte müssen die Ausgangswerte und die für den Dienst akzeptablen Auswirkungen berücksichtigen; universelle Werte gibt es nicht. Ein Anstieg der Fehler auf einer kritischen Route kann beispielsweise eine Pause rechtfertigen, auch wenn der globale Durchschnitt stabil bleibt.
Dokumentieren Sie auch das Verfahren: Wer ändert das Routing, wie wird die Kandidatenversion aus dem Traffic genommen, welche Prüfungen bestätigen, dass das Routing wieder auf die stabile Version gelenkt wird und diese erneut Traffic erhält, und wie wird der Vorfall kommuniziert? Pausieren und Rollback sind nicht dasselbe: Eine Pause stoppt die Aktivierung oder Ausweitung, während die Ursache untersucht wird; ein Rollback bringt den Dienst gemäß einem validierten Verfahren auf die vorherige Version zurück.
Ein Code-Rollback macht Änderungen an Daten, bereits versendete Nachrichten oder externe Vorgänge nicht automatisch rückgängig. Deshalb muss ein schneller Rollback als Teil des Plans getestet werden und den Zustand berücksichtigen, der nach der Veröffentlichung bestehen bleibt.
Gemeinsam genutzte Daten und paralleler Betrieb von Versionen
Die Datenbank ist häufig der kritischste Punkt. Wenn die neue Version sofort eine Spalte oder ein Format voraussetzt, das die stabile Version nicht versteht, können beide nicht sicher parallel betrieben werden. Entwerfen Sie kompatible Änderungen in einer Reihenfolge, die den laufenden Betrieb ermöglicht: Bereiten Sie zuerst kompatible Strukturen vor, stellen Sie anschließend Code bereit, der damit arbeiten kann, und entfernen Sie das Alte erst später, wenn keine Version es mehr benötigt.
Wenden Sie denselben Ansatz auf Caches, Sessions, Queues und interne API-Verträge an. Prüfen Sie, wie sich Konsumenten und Produzenten während des Übergangs verhalten, und verhindern Sie, dass zwei Versionen inkompatible Zustände schreiben. Lässt sich diese Kompatibilität nicht sicherstellen, muss die Migration möglicherweise vom Deployment getrennt oder eine andere Strategie gewählt werden.
Ablauf und Checkliste
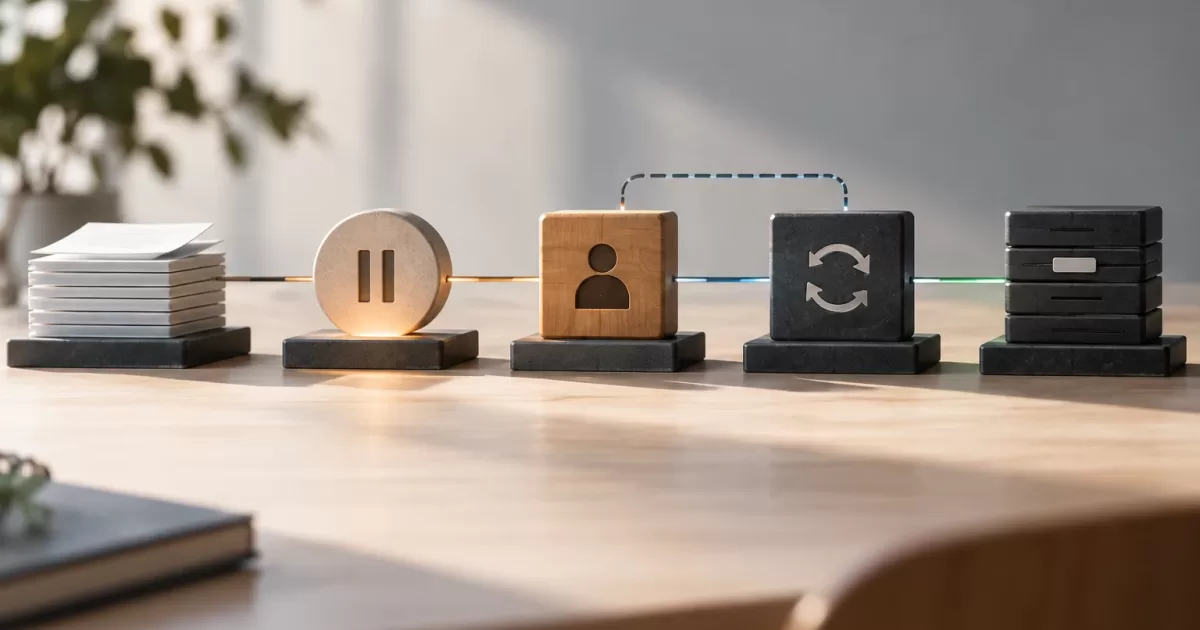
Ein klarer Betriebsablauf reduziert spontane Entscheidungen: Stellen Sie die Kandidatenversion bereit, prüfen Sie vor der Traffic-Zuweisung ihren Zustand, aktivieren Sie die anfängliche Nutzergruppe, beobachten Sie die vereinbarten Signale, entscheiden Sie über Ausweitung, Pause oder Rollback und dokumentieren Sie die Entscheidung. Halten Sie nach jeder Phase die Version, die Nutzergruppe, den beobachteten Zeitraum, die Vorfälle und die verantwortliche Person fest.
Prüfen Sie vor dem Start:
- Die Versionen können parallel betrieben werden und es gibt ausreichende Kapazitäten dafür.
- Das Routing und sein Rollback wurden getestet.
- Gemeinsam genutzte Daten und Zustände sind während des Übergangs kompatibel.
- Die Metriken unterscheiden die Versionen und verfügen über einen aussagekräftigen Ausgangswert.
- Schwellenwerte, Zuständigkeiten sowie Schritte für Pause und Rollback sind vereinbart.
- Das Team weiß, welche Auswirkungen nicht automatisch rückgängig gemacht werden können.
Fehlen mehrere dieser Voraussetzungen, sollten Sie zunächst Tests, Observability und die Kontrolle der Veröffentlichung verbessern, bevor Sie zusätzliche Komplexität einführen. Ein Canary Deployment ist eine Architektur- und Betriebsentscheidung, nicht bloß eine Option in der Pipeline: Es ist dann wertvoll, wenn sich daraus Erkenntnisse aus echtem Traffic gewinnen lassen und das Team handeln kann, bevor eine Regression die gesamte Nutzergruppe erreicht.