Un rapprochement des paiements compare les données enregistrées par une application aux informations reçues des systèmes qui traitent ou règlent ces paiements. Son objectif n’est pas de faire coïncider les données à tout prix : il s’agit d’identifier ce qui concorde, ce qui peut être expliqué et ce qui nécessite une enquête. Dans une application PHP, cette distinction doit se refléter à la fois dans les règles et dans le flux opérationnel.
La règle principale est simple : détecter un écart n’autorise pas à modifier les soldes, les statuts ni les écritures comptables. Un rapprochement fiable conserve les données d’origine, présente les éléments de preuve disponibles et réserve les décisions sensibles à une personne habilitée ou à un processus reposant sur des règles explicites et vérifiables.
Définir le périmètre et les sources de référence
Avant de mettre en œuvre le rapprochement des paiements en PHP, précisez quelles entités sont comparées et pour quelle période. Les encaissements, les remboursements, les rétrofacturations, les commissions et les règlements peuvent avoir des cycles de vie et des calendriers différents. Comparer uniquement le total quotidien des ventes, par exemple, peut masquer des remboursements ou des paiements réglés à une autre date.
Définissez également la granularité : opération individuelle, lot de règlement ou récapitulatif par période. Un rapprochement par opération permet d’examiner des cas précis ; un rapprochement des règlements aide à expliquer les montants transférés. Dans de nombreux systèmes, il est préférable de conserver ces deux perspectives et de les relier, plutôt que d’attendre d’un seul rapport qu’il réponde à toutes les questions.
Il n’existe pas toujours une source de référence unique. Le système interne peut faire autorité pour la commande et son client ; le système de paiement, pour l’identifiant de l’opération traitée ; et le relevé bancaire ou de règlement, pour le transfert effectivement reçu. Documentez la source qui fait autorité pour chaque attribut et la signification de chaque statut. En cas de désaccord, cette définition guide l’enquête ; il ne faut pas choisir automatiquement la valeur la plus récente.
Définir les clés de correspondance et la normalisation
La mise en correspondance doit d’abord s’appuyer sur des identifiants stables partagés, comme l’identifiant d’une opération externe enregistré lors du traitement du paiement. Selon le flux, il peut être nécessaire d’inclure le type de mouvement, le compte ou l’entité commerciale et la devise. L’identifiant de commande ne suffit pas à lui seul si une commande peut donner lieu à plusieurs tentatives de paiement, à des remboursements partiels ou à plusieurs opérations.
Évitez de faire correspondre des enregistrements uniquement en fonction du montant et de la proximité des dates. Ces données peuvent suggérer des candidats à examiner, mais ne permettent pas toujours d’identifier une opération sans ambiguïté. Si la source ne fournit pas de clé fiable, classez le résultat comme ambigu et indiquez les champs à l’origine de la suggestion. Ne transformez pas une correspondance probable en confirmation silencieuse.
Normalisez les valeurs pour les comparer, mais conservez exactement les données reçues et leur contexte. Pour les montants, utilisez une représentation décimale adaptée au domaine — par exemple, des unités mineures entières ou une arithmétique décimale — et évitez les nombres à virgule flottante. Comparez également la devise : deux montants numériquement identiques dans des devises différentes ne représentent pas la même somme. Conservez aussi le montant brut, la commission et le montant net comme des notions distinctes.
Les dates nécessitent une règle documentée. Stockez l’instant et le fuseau horaire d’origine lorsqu’ils sont disponibles, et distinguez les dates d’autorisation, de capture et de règlement. Pour les statuts, associez les valeurs externes à des catégories internes sans supprimer le statut d’origine. Un statut inconnu doit rester visible comme non reconnu, et ne pas être transformé par défaut en « échoué » ou « terminé ».
Classer les résultats sans masquer l’incertitude
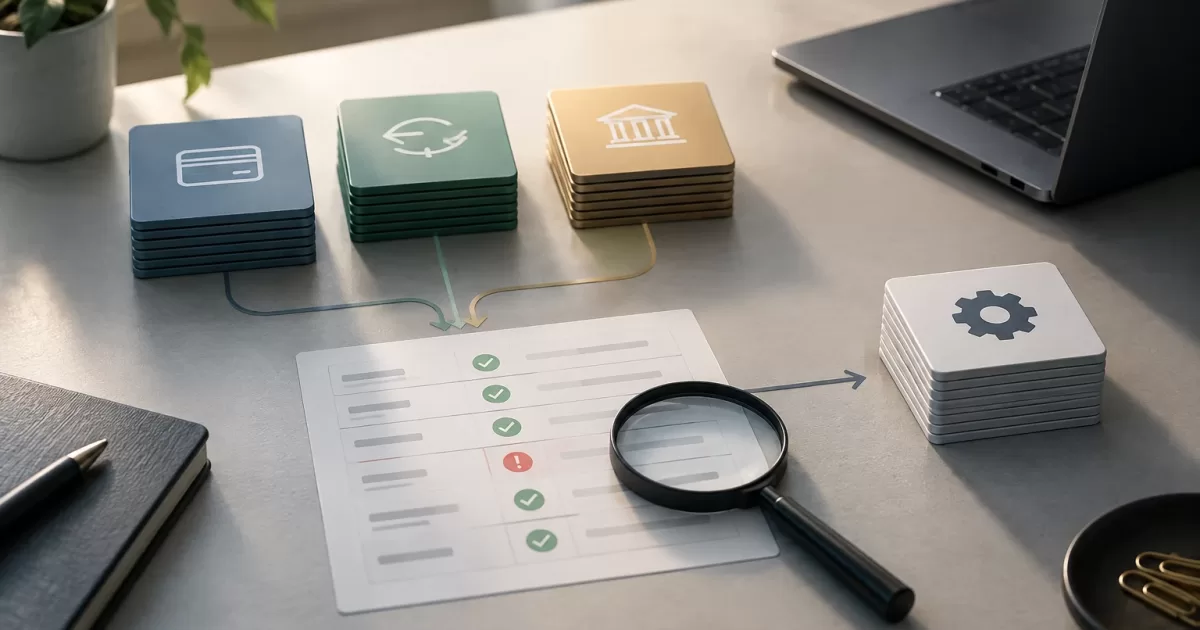
Un résultat lisible aide les équipes opérationnelles et techniques à distinguer les cas résolus de ceux qui nécessitent une intervention. Au minimum, classez chaque comparaison dans les catégories suivantes :
- Correspondance : les enregistrements correspondent et les champs pertinents concordent selon des règles explicites.
- Écart explicable : une règle documentée, telle qu’une commission prévue ou un décalage de règlement, explique la variation.
- Écart en attente : les enregistrements sont liés, mais diffèrent sur un champ important et les éléments disponibles ne suffisent pas à clore le cas.
- Sans correspondant : un enregistrement d’une source n’a pas de correspondant dans l’autre source au sein de l’ensemble rapproché.
- Ambigu ou incomplet : des données sont manquantes ou plusieurs correspondances sont possibles.
La classification doit expliquer la raison, et ne pas se limiter à une étiquette. Indiquez, par exemple, si le problème tient à un montant différent, à une devise manquante, à un événement tardif ou à un identifiant inconnu. Distinguez une donnée absente d’une donnée dont la valeur est zéro : elles ne sont pas équivalentes et peuvent nécessiter des actions différentes.
Concevoir un processus de révision auditable et sécurisé
La file de révision doit présenter les enregistrements des deux sources, les valeurs d’origine, les champs normalisés, la règle appliquée et tout élément de preuve associé, comme le fichier source ou l’identifiant du lot. Elle doit également indiquer qui a examiné le cas, quand, quelle décision a été prise et pourquoi. Si une donnée est corrigée, conservez la valeur précédente et l’historique de la modification conformément aux politiques d’accès et de conservation applicables.
Séparez la détection de la résolution. Un écart peut être clôturé comme expliqué, confirmé comme une erreur de source ou transmis pour enquête. Si l’équipe décide de créer un ajustement, exigez une autorisation, un motif et une référence aux éléments de preuve ; enregistrez l’ajustement comme un mouvement traçable au lieu d’écraser l’enregistrement d’origine. Le système ne transformera ainsi pas une hypothèse de rapprochement en fait financier.
Appliquez des contrôles d’accès proportionnés à l’impact : les personnes qui consultent les rapports n’ont pas toutes besoin de pouvoir approuver des ajustements. Consignez les décisions et les modifications des autorisations, et évitez d’exposer des données personnelles inutiles à l’examen de l’écart. Pour les tâches automatisées, définissez des alertes et un circuit d’escalade lorsqu’une source échoue ou qu’un lot ne peut pas être validé.
Retraiter les lots sans dupliquer les effets
Les fichiers peuvent arriver en retard, être répétés ou nécessiter une nouvelle importation après la correction d’un problème. Concevez le traitement de manière à ce qu’il soit idempotent : la réception répétée du même lot ne doit pas créer de mouvements, de cas ni d’ajustements en double. Une clé d’idempotence peut être dérivée d’un identifiant stable de l’événement ou du lot, à condition que sa portée soit clairement définie et que des contraintes d’unicité soient appliquées dans la base de données.
Séparez la réception du fichier, sa validation, sa normalisation et la comparaison. Enregistrez les métadonnées du lot — origine, période, empreinte ou identifiant, date de réception et résultat de validation — et évitez de le marquer comme traité si une étape essentielle a échoué. Pour les lots volumineux, procédez par unités récupérables et consignez l’avancement. Un retraitement doit pouvoir recalculer le résultat sans répéter d’effets externes ni supprimer des décisions humaines antérieures.
Lorsque le format d’entrée change ou qu’un enregistrement tardif apparaît, déterminez s’il faut recalculer une période, mettre à jour un cas existant ou en ouvrir un nouveau. Conservez le lien entre les versions des données et les exécutions afin qu’une personne puisse savoir quelles informations ont servi à une décision antérieure.
Tester les règles et mesurer le fonctionnement opérationnel
Testez les règles avec des cas représentatifs des risques réels du flux : doublons, événements dans le désordre, remboursements partiels, montants présentant des écarts d’arrondi, devises différentes, clés manquantes, statuts inconnus et enregistrements arrivant après la clôture initiale. Incluez des tests d’idempotence qui retraitent la même entrée et vérifient qu’aucun effet supplémentaire n’est créé. Les tests d’intégration doivent également valider le format réel des sources et le comportement en cas d’erreurs partielles.
En production, surveillez le volume d’enregistrements sans correspondant, l’ancienneté des écarts, les cas ambigus, les lots en échec et le délai de résolution. Interprétez ces signaux en tenant compte des changements de format, des retards de livraison et de l’activité commerciale : une hausse ne prouve pas à elle seule l’existence d’une erreur financière, mais elle peut signaler une régression ou une source incomplète.
La procédure de clôture doit préciser qui mène l’enquête, qui approuve un ajustement et quels éléments de preuve sont suffisants. Si un écart ne peut pas être expliqué, il reste en attente et visible jusqu’à ce qu’une décision soit documentée. Cette discipline fait du rapprochement des paiements en PHP un mécanisme de contrôle opérationnel, et non une routine qui se contente de faire disparaître les écarts.