Une réponse paginée peut être correcte au moment de son exécution et pourtant produire un parcours incohérent. Si une application demande une page, que l’ensemble de données change, puis qu’elle demande la suivante, elle peut recevoir des éléments en double ou ne jamais en voir d’autres. C’est un problème courant dans les listes d’activité, de commandes et d’enregistrements qui continuent de s’étoffer.
La pagination par curseur dans une API PHP aide à maîtriser ce décalage, mais ne garantit pas à elle seule une vue figée des données. La décision importante consiste à définir ce que signifie avancer dans la liste, quels changements peuvent survenir pendant le parcours et quel contrat le client attend.
Pourquoi les résultats changent d’une page à l’autre
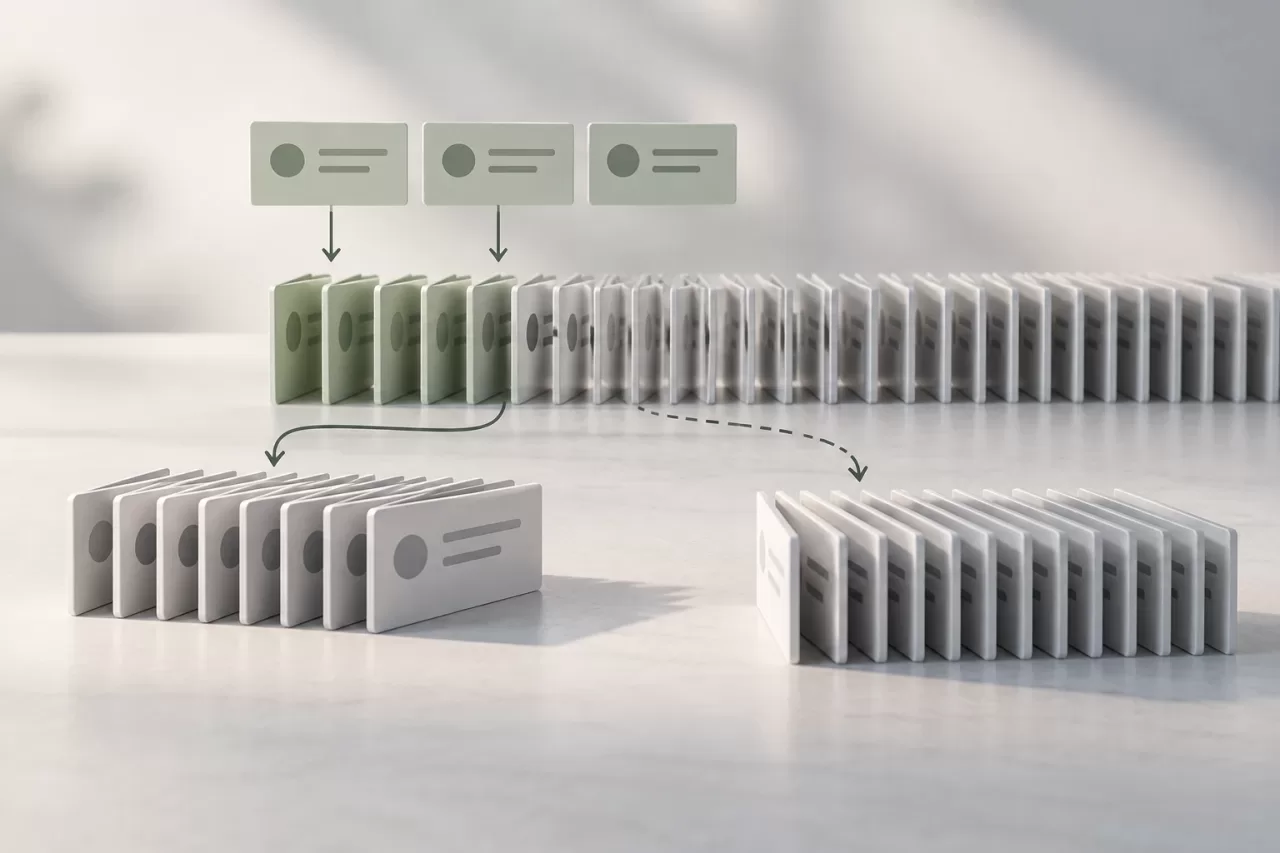
Supposons qu’une requête trie les enregistrements par date décroissante. Le client récupère les 20 premiers. Avant qu’il ne demande les suivants, trois enregistrements récents sont insérés. Si la deuxième requête utilise OFFSET 20, elle commence à la position 21 de l’ensemble actuel, et non à la position 21 de l’ensemble tel qu’il était lors de la première requête. Certains éléments de la première page peuvent réapparaître.
Des omissions sont également possibles. Si un enregistrement situé avant le décalage est supprimé, les éléments suivants avancent d’une position et une ligne que le client s’attendait à trouver peut être omise. L’ordre n’est pas non plus nécessairement stable lorsque plusieurs lignes ont la même date : sans critère supplémentaire, la base de données n’est pas tenue de toujours renvoyer ces lignes ex æquo dans le même ordre.
Il convient de distinguer deux objectifs : éviter les sauts dus aux changements de position et fournir un instantané exact de l’ensemble complet. Une pagination par curseur bien définie aide à atteindre le premier. Le second nécessite une stratégie de cohérence explicite, qui peut être plus coûteuse et dépendre de la base de données.
Offset ou curseur : choisissez selon le mode de lecture
La pagination par décalage, généralement exprimée avec LIMIT et OFFSET, est simple et permet d’accéder directement à une page connue. Elle peut convenir aux petits ensembles ou aux ensembles relativement statiques, aux interfaces qui passent fréquemment d’une page à l’autre et aux cas où les incohérences pendant la navigation sont acceptables. Sur les grands ensembles, les décalages élevés peuvent obliger la base de données à parcourir ou à ignorer de nombreuses lignes ; le coût réel dépend du moteur, des index et de la requête.
La pagination par curseur renvoie une référence au point à partir duquel poursuivre, par exemple la dernière valeur de tri et sa clé unique. La requête suivante recherche les enregistrements situés après ou avant ce point, au lieu de sauter un certain nombre de lignes. Cette approche convient aux parcours séquentiels, aux flux et aux listes qui reçoivent fréquemment des insertions. En revanche, elle ne permet pas naturellement d’accéder à une page arbitraire : le client doit parcourir les pages ou disposer d’une autre stratégie.
Le choix n’a pas besoin d’être le même pour toute l’API. Vous pouvez exposer une pagination par offset dans une requête administrative avec des pages numérotées, et une pagination par curseur dans un flux d’activité. L’interface doit refléter ce que le serveur peut garantir, au lieu de promettre à la fois une navigation aléatoire et une stabilité absolue avec un mécanisme unique.
Définissez un ordre total avant de créer le curseur
Le curseur n’identifie une position que si l’ordre est déterministe. Un tri uniquement sur created_at ne suffit pas lorsque deux enregistrements ont la même date. Ajoutez une colonne unique et immuable comme critère de départage, par exemple id :
ORDER BY created_at DESC, id DESCAinsi, chaque ligne occupe une position définie dans l’ordre. Le curseur de continuation doit contenir les deux valeurs. Pour le même ordre décroissant, la requête suivante recherche les paires inférieures à la dernière paire renvoyée :
WHERE created_at < :cursor_date
   OR (created_at = :cursor_date AND id < :cursor_id)
ORDER BY created_at DESC, id DESC
LIMIT :page_size
Pour un ordre croissant, les comparaisons sont inversées. Avec plusieurs critères, les conditions doivent respecter l’ordre lexicographique complet : on compare d’abord le premier champ et, en cas d’égalité, le suivant. Si les directions sont mixtes — par exemple, date décroissante et identifiant croissant —, chaque comparaison doit correspondre à la direction de sa colonne. Il ne suffit pas d’inverser tous les opérateurs en même temps.
Les valeurs de tri doivent également obéir à des règles stables. Si une colonne peut être nulle, définissez l’ordre de ces valeurs et encodez cette distinction dans la condition de continuation. Il est préférable d’utiliser des critères immuables pendant le parcours : si une date qui détermine la position est modifiée, une ligne peut passer d’un côté à l’autre du curseur.
Rendez le curseur opaque, validé et lié à la requête
Un curseur peut sérialiser les valeurs de tri et les encoder, par exemple avec Base64URL. Son opacité signifie que le consommateur n’a pas besoin de l’interpréter ni de le construire ; cela ne signifie pas que Base64 le protège. Si la modification de ses valeurs peut changer le périmètre de la requête, validez son format et signez son contenu avec un HMAC ou utilisez un mécanisme d’intégrité équivalent. N’y incluez pas de secrets ni de données personnelles inutiles.
Validez les types, les champs attendus, la version du format et les limites de taille avant d’interroger la base de données. Utilisez des paramètres SQL pour les valeurs. Les noms de colonnes et les directions de tri ne doivent pas être acceptés directement depuis le curseur ou la requête : ils doivent provenir d’une liste autorisée côté serveur.
Un curseur contenant une date et un identifiant ne doit pas pouvoir être réutilisé accidentellement avec des filtres différents si cela produit une continuation trompeuse. Vous pouvez inclure une représentation canonique des filtres pertinents, le sens du tri et, le cas échéant, la taille de page, puis signer ces éléments avec le point de continuation. S’ils ne correspondent pas à la requête actuelle, renvoyez une erreur explicite au lieu de poursuivre silencieusement avec une autre requête. En PHP, centralisez l’encodage, la validation et la signature afin de ne pas dupliquer les règles entre contrôleurs.
Déterminez le niveau de cohérence à offrir en cas de changements concurrents
Lors d’un parcours sur des données vivantes, chaque page interroge l’état disponible à ce moment-là. Un curseur basé sur un ordre immuable évite de nombreux décalages provoqués par des insertions antérieures au point atteint. Mais il ne crée pas d’instantané : de nouvelles lignes peuvent apparaître après le curseur, des lignes non encore consultées peuvent être supprimées, et les autorisations ou filtres applicables peuvent changer. Documentez ce comportement afin que le client ne le confonde pas avec un export figé.
Si le produit exige que toutes les pages représentent un ensemble délimité, une option consiste à fixer une borne, par exemple une date ou un identifiant maximal, au début du parcours, puis à l’ajouter à chaque requête. Lorsque le critère choisi le permet, cela exclut les insertions postérieures à cette borne, mais ne préserve pas les lignes supprimées et ne garantit pas un instantané parfait en cas de modifications. Un instantané transactionnel est une autre possibilité ; maintenir une transaction ouverte entre les requêtes a généralement des implications opérationnelles et de ressources. Il ne faut donc pas le considérer comme la solution par défaut.
Le contrat peut préciser des limites claires : l’ordre pris en charge, les filtres à conserver, la durée de validité éventuelle, le comportement en cas de curseur invalide et la possibilité que les changements concurrents modifient l’ensemble. Ne promettez pas une absence absolue de doublons ou d’omissions si la stratégie ne peut pas la garantir.
Testez les cas limites et documentez le contrat
Les tests doivent vérifier le parcours complet, et pas seulement la forme d’une réponse. Préparez des lignes avec des valeurs de tri répétées et vérifiez que plusieurs pages concaténées respectent l’ordre attendu, sans doublons. Incluez des cas où la taille de page coupe un groupe de valeurs ex æquo et validez les sens croissant et décroissant.
- Insérez des enregistrements avant et après le curseur entre deux requêtes et vérifiez le comportement convenu.
- Supprimez une ligne en attente et modifiez une colonne de tri, si le modèle de données le permet ; documentez-en les conséquences.
- Modifiez un filtre, l’ordre ou le sens du parcours, et vérifiez qu’un curseur incompatible est rejeté.
- Envoyez des curseurs mal formés, altérés, trop volumineux ou contenant des valeurs de types incorrects.
- Vérifiez les limites de taille de page et le cas sans résultat, y compris l’absence de page suivante.
Pour le diagnostic, enregistrez des métriques de durée des requêtes, de taille des pages et d’erreurs de validation, sans exposer de curseurs sensibles ni de données personnelles. En cas de répétitions, vérifiez d’abord l’ordre total et la condition de continuation. Si le problème concerne le coût des requêtes, examinez le plan d’exécution et les index sur les champs de tri et les conditions de filtre.
Une pagination stable ne dépend pas de la dissimulation d’une chaîne en Base64 : elle repose sur un ordre déterministe, une comparaison cohérente, des filtres maîtrisés et des attentes explicites concernant les changements concurrents. Avec ces choix, offset et curseur deviennent des outils que l’on peut sélectionner en fonction du parcours réellement nécessaire au client.