

Lorsqu’une opération traverse une requête HTTP, une file d’attente et un ou plusieurs services externes, ses journaux sont répartis entre différents processus. Sans donnée commune, l’analyse d’un incident oblige à effectuer des recherches par heure, utilisateur ou contenu, des critères qui peuvent être ambigus ou sensibles. Un identifiant de corrélation en PHP permet de regrouper les événements liés à une opération et d’en reconstituer le parcours.
Pour fonctionner, l’identifiant doit avoir une origine définie, être transmis explicitement au franchissement des limites asynchrones et apparaître de manière cohérente dans les journaux. Ce n’est ni une solution d’observabilité complète ni un identifiant d’authentification : il sert à relier des événements, pas à expliquer à lui seul ce qui a échoué ni qui est autorisé.
Ce qu’il permet de résoudre et ce qui n’en relève pas
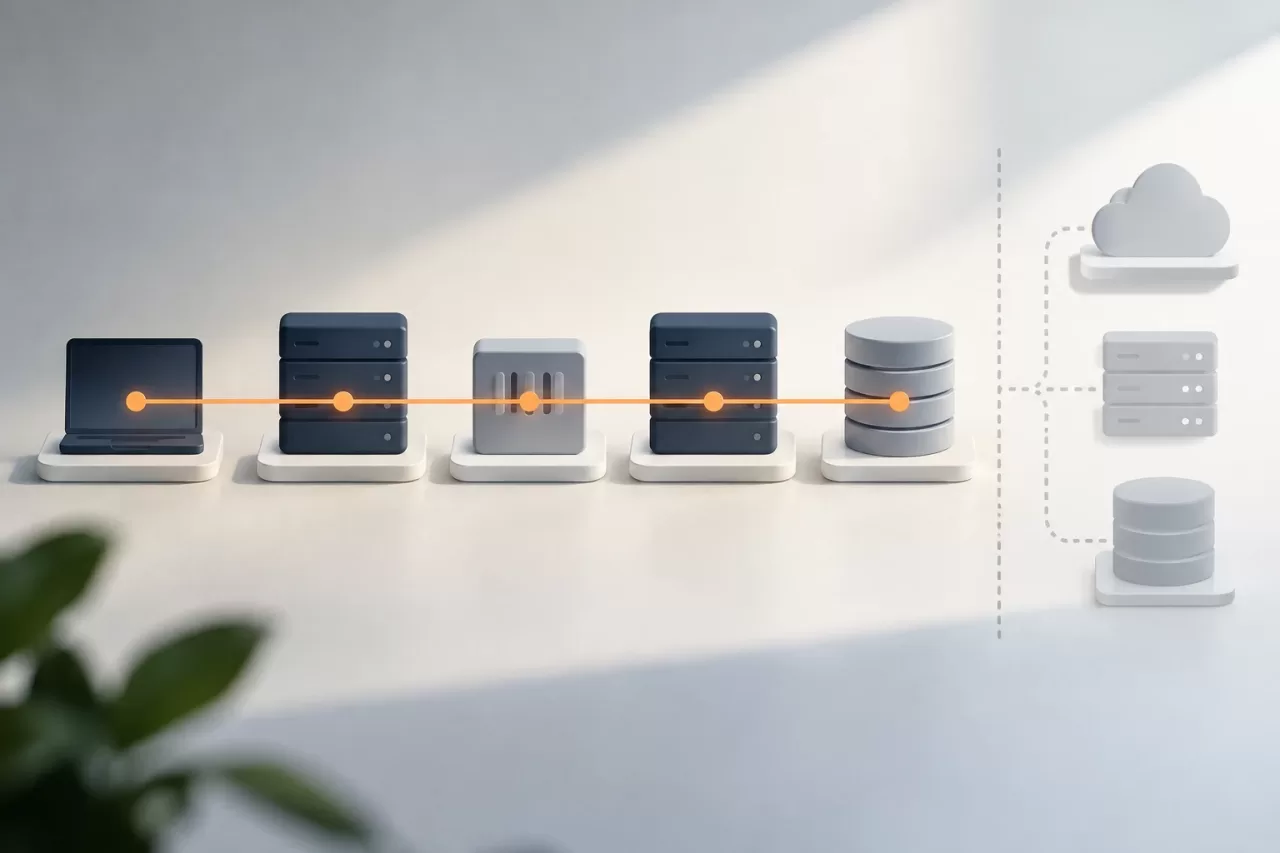
Un identifiant de corrélation est une valeur opaque associée à une requête ou à une opération. Son intégration aux journaux de l’application permet de retrouver les messages produits par différents composants qui partagent cette valeur. Il est ainsi possible de relier la réception d’une requête à la mise en file d’un travail, à son traitement et à la réponse d’une API externe.
Cela améliore le diagnostic lorsque les journaux sont centralisés et consultables par champ. Toutefois, cela ne garantit pas que tous les composants aient correctement enregistré l’identifiant, et ne mesure ni la durée, ni le volume, ni les erreurs agrégées. Les métriques servent à repérer des tendances et à déclencher des alertes ; les traces distribuées montrent les relations et les temps entre composants ; les journaux fournissent les événements et leur contexte. Ce sont des signaux complémentaires.
Il ne faut pas non plus confondre corrélation, authentification, autorisation et identité de l’utilisateur. La connaissance d’un identifiant ne devrait ni donner accès à des données ni permettre d’exécuter une opération. Si la valeur est exposée dans une URL ou dans un système tiers, elle peut être visible par davantage de personnes que prévu.
Définir où l’identifiant est généré et comment il est validé
Dans une application, le point de départ habituel du contexte est le middleware HTTP qui reçoit la requête. Il peut accepter un identifiant entrant pour assurer la continuité avec un proxy ou un service précédent, ou en générer un nouveau s’il n’en existe pas. La politique doit être explicite : faire confiance à toutes les valeurs externes peut permettre l’introduction de valeurs malformées, trop longues ou conçues pour polluer les journaux.
Pour le trafic public, une option sûre consiste à toujours générer un identifiant interne et, si la conservation de la valeur entrante est nécessaire, à la traiter comme une donnée non fiable et à la valider strictement. Une autre solution consiste à n’accepter la valeur de l’en-tête que depuis des composants de confiance, selon des règles configurées à la périphérie du système. Le choix dépend de l’architecture et des entités autorisées à appeler le service.
Le format doit être facile à valider et compatible avec les systèmes qui le transportent. On peut utiliser une valeur aléatoire générée par une source cryptographique du système, comme random_bytes(), et encodée dans un alphabet limité. Il est déconseillé de la construire à partir d’horodatages, d’adresses IP ou de données personnelles. Un identifiant unique n’a pas besoin de révéler des informations métier.
$correlationId = bin2hex(random_bytes(16));
Cet exemple génère une valeur aléatoire hexadécimale ; il ne prescrit pas de format universel. Définissez une longueur maximale, les caractères autorisés et l’en-tête utilisé par les composants, par exemple X-Correlation-ID. Si la plateforme adopte déjà un standard de traçage, évitez de créer sans nécessité un mécanisme parallèle : la corrélation des journaux et le contexte de trace peuvent coexister, mais ce ne sont pas des notions identiques.
Propager le contexte à chaque frontière
Dans le middleware, validez ou créez l’identifiant au début de la requête et ajoutez-le au contexte de journalisation. Si vous le renvoyez au client dans une réponse, assurez-vous qu’aucune information supplémentaire n’est exposée et que la politique de confiance est claire. Le reste de l’application devrait recevoir le contexte par une dépendance explicite, plutôt que de dépendre de variables globales difficiles à tester.
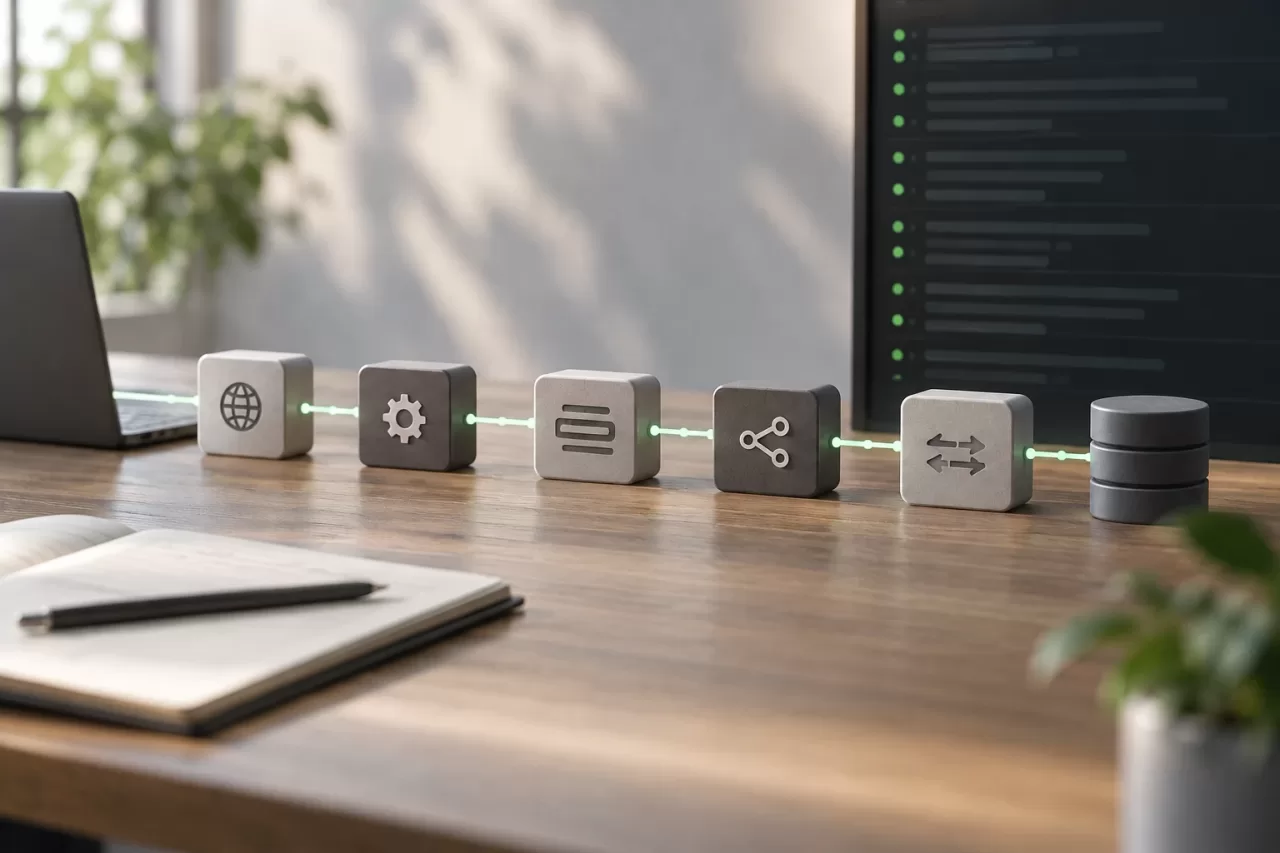
Au sein du processus PHP, transmettez l’identifiant aux services qui enregistrent des événements pertinents. Pour les travaux asynchrones, incluez-le dans les métadonnées du message ou dans un champ dédié de la charge utile, selon les conventions du système de files d’attente. Lors du traitement du message, rétablissez le contexte avant d’exécuter le travail et effacez-le une fois celui-ci terminé. C’est particulièrement important dans les processus de longue durée, où un même worker traite des messages successifs : un contexte qui n’a pas été effacé peut se retrouver associé à une autre opération.
Lors d’un appel à une API externe, transmettez la valeur dans un en-tête convenu uniquement si le fournisseur le prend en charge et si son partage est approprié. N’envoyez pas de données internes inutiles. Pour les intégrations qui ne conservent pas les en-têtes, enregistrez l’identifiant avec le résultat local de l’appel ; ne supposez pas que le système distant le renverra dans ses propres journaux.
Si une requête produit plusieurs travaux indépendants, chacun peut conserver l’identifiant de l’opération d’origine. En revanche, s’il est nécessaire de distinguer des sous-opérations, ajoutez un identifiant propre à chacune et maintenez le lien au moyen du contexte de trace ou de champs métier non sensibles. Évitez de réutiliser la même valeur avec des sémantiques différentes sans les documenter.
L’utiliser dans des journaux structurés, sans remplacer l’observabilité
Enregistrez l’identifiant dans un champ structuré, par exemple correlation_id, plutôt que de l’intégrer uniquement à une phrase en texte libre. Une plateforme de journaux peut ainsi filtrer et regrouper les événements sans dépendre de recherches approximatives. Adoptez une convention uniforme entre l’application, les workers et les intégrations, et vérifiez que le sérialiseur ne l’omet pas.
Incluez-le dans les événements utiles au diagnostic : réception de la requête, création du message, début et fin du travail, et résultat d’un appel externe. Il n’est pas nécessaire de le répéter sur chaque ligne si le système fournit un contexte persistant par opération. Dans ce cas, vérifiez que le contexte est réinitialisé entre les requêtes et que les journaux restent interprétables lorsqu’un composant ne le prend pas en charge.
N’utilisez pas l’identifiant comme étiquette de métrique à forte cardinalité. Créer une série temporelle par requête peut augmenter les coûts et rendre les métriques peu utiles. N’enregistrez pas non plus à ses côtés des jetons, des mots de passe, des données de paiement, le contenu intégral des messages ni des informations personnelles qui ne sont pas nécessaires. Appliquez les règles de l’organisation en matière de minimisation, d’accès et de conservation des journaux.
Réessais, exécutions différées et défaillances
Un nouvel essai du même travail conserve généralement l’identifiant de corrélation d’origine : il relève toujours de la même opération logique. Pour distinguer les tentatives, enregistrez un numéro de tentative ou un identifiant qui lui est propre, sans remplacer le contexte d’origine. Il est ainsi possible d’analyser à la fois le parcours complet et la cause de chaque exécution.
Si l’exécution d’un travail est programmée beaucoup plus tard, conservez l’identifiant comme métadonnée persistante ; ne dépendez ni de la mémoire du processus ni d’une session HTTP déjà terminée. Si le travail lance une opération nouvelle et autonome, définissez si elle hérite du contexte d’origine ou si elle en reçoit un nouveau, et enregistrez le lien entre les deux. Cette décision évite qu’une corrélation trop large ne mélange des tâches sans rapport entre elles.
Lorsque la file d’attente ou un service externe supprime les métadonnées, documentez cette limite et conservez le contexte dans le composant que vous contrôlez. L’application doit rester exploitable en l’absence de l’identifiant : générez-en un à l’entrée du processus ou indiquez clairement dans les journaux que le contexte n’était pas disponible.
Tests et vérifications opérationnelles
- Testez le middleware avec un identifiant absent, valide et malformé ; confirmez qu’il applique la politique définie et que la valeur respecte les limites.
- Vérifiez que l’identifiant de la requête apparaît dans les journaux des services internes et dans les métadonnées du message envoyé dans la file d’attente.
- Traitez un message dans un worker et vérifiez que le contexte est ajouté aux journaux, puis effacé avant le message suivant.
- Simulez un nouvel essai et confirmez que la corrélation d’origine est conservée et que la tentative peut être distinguée.
- Vérifiez la sortie de l’appel externe et le traitement des erreurs, sans exposer de secrets ni de corps de message sensibles dans les journaux.
- Vérifiez que les tableaux de bord et les alertes ne reposent pas sur la recherche d’identifiants individuels dans les métriques.
Une vérification de bout en bout doit suivre une opération de test depuis l’entrée HTTP jusqu’au travail et à son intégration, en interrogeant les journaux à l’aide du même champ. S’il manque sur une étape, identifiez la frontière exacte : middleware, sérialisation du message, consommateur, client HTTP ou configuration du logger. Cette observation indique où corriger la propagation, au lieu d’ajouter des journaux sans discernement.
En pratique, il s’agit de conserver un contexte limité, explicite et non sensible, assorti de règles claires de confiance et de cycle de vie. L’identifiant de corrélation en PHP réduit ainsi le temps de recherche lors d’un incident, sans remplacer les contrôles de sécurité, les traces, les métriques ni une conception soignée des journaux.


