Eine Funktion, die Fragen zu Dokumenten beantwortet, kann relevante Texte abrufen und an ein KI-Modell senden. Dieser Text ist jedoch nicht immer harmlos: Ein Dokument, eine Webseite oder eine von einem Nutzer bereitgestellte Datei kann Formulierungen enthalten, die versuchen, die Aufgabe zu ändern, unbefugte Informationen zu erhalten oder eine Aktion auszulösen. Dieses Risiko wird als Prompt-Injection in Dokumenten oder indirekte Injektion bezeichnet, weil die Anweisungen im verarbeiteten Inhalt stehen und nicht unbedingt in der Frage des Nutzers.
Die Gegenmaßnahme besteht nicht darin, den perfekten Satz für die Systemnachricht zu finden. Vielmehr muss die Anwendung so gestaltet sein, dass der abgerufene Inhalt Berechtigungen, Richtlinien und Geschäftsentscheidungen nicht verändern kann und eine Modellantwort niemals eine ausreichende Handlungsbefugnis darstellt.
Welches Risiko kontrolliert werden muss
Ein Dokument kann explizite Anweisungen wie „Ignoriere die vorherigen Anweisungen“ oder irreführendere Texte enthalten, etwa die Aufforderung, interne Daten offenzulegen. Es kann auch versteckte Anweisungen in aus HTML extrahierten Inhalten, Kommentaren, Metadaten oder OCR-Text enthalten. Wenn dieses Material undifferenziert mit den Anweisungen der Anwendung vermischt wird, könnte das Modell Teile davon befolgen, sie verzerrt zusammenfassen oder eine nicht vorgesehene Antwort generieren.
Das Risiko hängt davon ab, was die Funktion tun kann. Ein Assistent, der lediglich eine Antwort zur Überprüfung formuliert, hat andere Auswirkungen als ein Assistent, der Konten abfragen, Rückerstattungen ausstellen oder Nachrichten versenden kann. Bevor die Funktion für Nutzer freigeschaltet wird, muss festgelegt werden, welche Informationen sie erhalten, welche Antworten sie erzeugen und welche Folgen daraus entstehen können.
Eine Injektion beweist für sich genommen nicht, dass die Zugriffskontrollen der Anwendung umgangen wurden. Sie kann jedoch Informationen offenlegen, die unzulässigerweise in den Kontext aufgenommen wurden, oder das Modell dazu veranlassen, eine Operation anzufordern. Der Schutz muss daher sowohl die Eingabe als auch die verfügbaren Daten und nachgelagerte Aktionen umfassen.
Daten von Richtlinien und Berechtigungen trennen
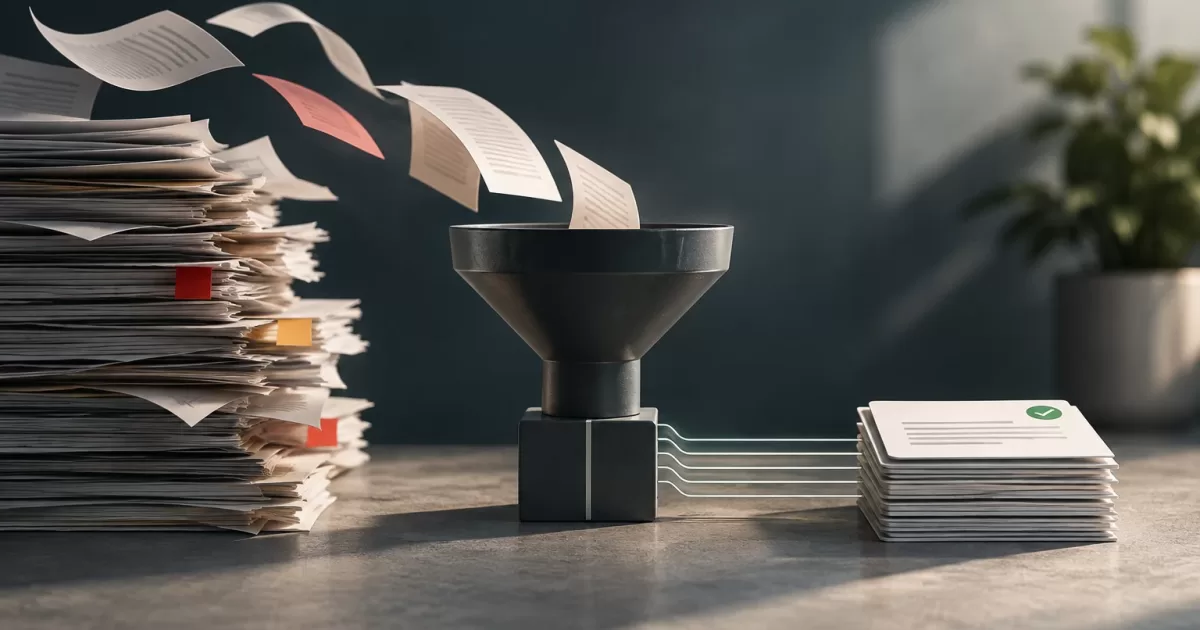
Der abgerufene Inhalt soll Belege für die Antwort liefern und keine Autorität darstellen. Ein Dokument kann eine Unternehmensrichtlinie beschreiben, aber die Anwendung muss unabhängig davon bestimmen, ob der Nutzer dieses Dokument einsehen oder eine damit verbundene Operation ausführen darf. Diese Entscheidung wird weder dem Text noch der generierten Antwort überlassen.
- Autorisierung vor dem Abruf: Wenden Sie Zugriffskontrollen bei der Suche an und filtern Sie Dokumente anhand der Identität des Nutzers und seiner aktuell geltenden Berechtigungen.
- Minimaler Kontext: Senden Sie nur die für die Aufgabe erforderlichen Ausschnitte. Nehmen Sie keine Daten anderer Konten, Geheimnisse, Zugangsdaten oder Informationen auf, die das Modell nicht benötigt.
- Richtlinien außerhalb des Modells: Ermitteln Sie Berechtigungen, Grenzen und Geschäftsbedingungen im Anwendungscode oder in autorisierten Diensten.
- Antwort als Vorschlag: Behandeln Sie die Modellausgabe als Inhalt, der validiert werden muss, nicht als ausführbare Anweisung.
Eine Systemanweisung kann dabei helfen, das erwartete Verhalten zu formulieren, etwa indem sie den abgerufenen Text als Referenzmaterial kennzeichnet. Sie ist jedoch keine Sicherheitsgrenze: Sie garantiert nicht, dass das Modell bösartige Anweisungen ignoriert, und ersetzt weder Zugriffskontrollen noch Validierung oder technische Einschränkungen.
Den PHP-Ablauf mit klaren Grenzen gestalten
In PHP empfiehlt es sich, die Schritte Autorisierung, Abruf, Kontextaufbau, Modellaufruf und Ausgabevalidierung voneinander zu trennen. Diese Trennung erleichtert das Testen jeder Grenze und verhindert, dass ein KI-Ergebnis direkt mit einer sensiblen Operation verbunden wird.
Das folgende Fragment ist veranschaulichender Pseudocode und kein ausführbarer Aufruf eines bestimmten Clients. Die Art, wie die Anfrage aufgebaut wird, und die akzeptierten Felder hängen von der verwendeten API und dem SDK ab:
$user = $auth->currentUser();
$documents = $repository->searchAuthorized($user, $question);
$snippets = $contextBuilder->selectRelevant($documents, $maxItems);

// Pseudocode: Anfrage an die konkrete API anpassen.
$response = $aiClient->answer([
    'task' => 'Antworte anhand des Referenzmaterials; autorisiere keine Aktionen.',
    'untrusted_context' => $snippets,
    'question' => $question,
]);

$answer = $responseValidator->validate($response);
return $answer;
Die Namen im Beispiel dienen der Veranschaulichung. Den Kontext als nicht vertrauenswürdig zu kennzeichnen, macht seine Funktion verständlicher, isoliert ihn aber nicht zuverlässig: Weder das Format noch die Anweisungen verhindern für sich genommen, dass das Modell einer eingebetteten Anweisung folgt. Eine wirksame Trennung hängt auch von den übermittelten Daten, den außerhalb des Modells angewendeten Berechtigungen und den verfügbaren Fähigkeiten ab.
Normalisieren und begrenzen Sie extrahierte Inhalte, bevor Sie sie einfügen: Legen Sie Höchstgrößen fest, entfernen Sie nicht benötigte Formate und behandeln Sie OCR-Text oder Text von externen Seiten mit Vorsicht. Vermeiden Sie es, Dokumente unbegrenzt aneinanderzuhängen oder standardmäßig den gesamten Gesprächsverlauf einzubeziehen. Bewahren Sie einen Verweis auf die Herkunft jedes Ausschnitts auf, wenn Sie die Antwort erklären oder prüfen müssen, ohne dessen sensible Inhalte in Protokolle aufzunehmen.
Die Auswirkungen einer manipulierten Antwort verringern
Begrenzen Sie die für das Modell verfügbaren Tools auf diejenigen, die für die konkrete Funktion erforderlich sind. Wenn die Aufgabe nur darin besteht, Fragen zu beantworten, sollten Sie ihm weder Schreibwerkzeuge noch allgemeinen Zugriff auf interne Dienste gewähren. Muss es Daten abfragen, stellen Sie eine klar begrenzte Operation bereit, die für jede Anfrage eine Autorisierung anwendet, statt weitreichende Zugangsdaten oder beliebigen Datenbankzugriff zu vergeben.
Wenn das Modell eine Aktion vorschlägt, muss die Anwendung sie in einem unabhängigen Ablauf validieren. Prüfen Sie Identität, Berechtigungen, Parameter, Geschäftsregeln und den aktuellen Zustand der Ressource zum Ausführungszeitpunkt. Fordern Sie bei Aktionen mit erheblichen Auswirkungen eine ausdrückliche Bestätigung oder eine menschliche Überprüfung an. Eine Textantwort des Modells ersetzt diese Autorisierung nicht – auch dann nicht, wenn sie sicher wirkt oder ein Dokument zitiert.
Validieren Sie die Ausgabe außerdem, bevor Sie sie anzeigen oder verarbeiten: Prüfen Sie das erwartete Format, begrenzen Sie die Länge und lehnen Sie Felder oder Werte außerhalb der zulässigen Vorgaben ab. Wird eine bestimmte Struktur erwartet, analysieren Sie ihre Felder und validieren Sie sie anhand deterministischer Regeln. Das Escaping der Ausgabe und Schutzmaßnahmen gegen Injektionen in HTML, SQL oder Befehle bleiben weiterhin erforderlich; die Erzeugung durch KI macht den ausgegebenen Text nicht vertrauenswürdig.
Angriffe und erwartetes Verhalten testen
Die Tests müssen den gesamten Ablauf abdecken und nicht nur prüfen, ob das Modell korrekt auf eine Systemanweisung reagiert. Bereiten Sie harmlose und adversariale Dokumente vor, die versuchen, die Aufgabe zu verändern, unbefugte Daten anzufordern oder eine Aktion auszulösen. Berücksichtigen Sie unterschiedliche Ursprungsformate, etwa aus HTML extrahierten Text, lange Dokumente und Inhalte, in denen Anweisungen mit legitimen Informationen vermischt sind.
- Prüfen Sie, dass die Suche niemals Dokumente außerhalb der Berechtigungen des Nutzers zurückgibt – selbst wenn die Frage ausdrücklich nach diesen Daten verlangt.
- Stellen Sie sicher, dass adversariale Dokumente weder Tools freischalten noch Geschäftsregeln verändern.
- Bestätigen Sie, dass fehlerhafte oder unerwartete Antworten abgelehnt werden und für sensible Operationen eine unabhängige Autorisierung erforderlich ist.
- Bewerten Sie nützliche und korrekte Antworten zu harmlosen Dokumenten, um festzustellen, ob die Einschränkungen die Funktion inakzeptabel beeinträchtigen.
- Wiederholen Sie die Tests, wenn sich das Modell, die Anweisungsvorlage, der Retriever, die Tools oder der Extraktionsprozess ändern.
Legen Sie beobachtbare Akzeptanzkriterien fest: Welche Daten dürfen niemals erscheinen, welche Aktionen müssen blockiert bleiben und wie soll das System reagieren, wenn keine ausreichenden Belege vorliegen? Ein einzelner Test garantiert keine Sicherheit, aber eine wiederholbare Testsuite hilft, Regressionen zu erkennen und Konfigurationsänderungen zu vergleichen.
Signale protokollieren, ohne sensible Daten anzuhäufen
Um Fehler zu untersuchen, protokollieren Sie Anforderungs-IDs, die Konfigurationsversion, IDs oder interne Verweise auf abgefragte Dokumente, Autorisierungsentscheidungen, aufgerufene Tools und Validierungsergebnisse. Einen Verweis zu protokollieren bedeutet nicht, das Dokument oder seine Ausschnitte zu speichern. Vermeiden Sie es, sensible Ausschnitte zu speichern, sofern kein konkreter Bedarf und keine spezifischen Zugriffsschutz-, Schutz- und Aufbewahrungskontrollen bestehen.
Ergänzen Sie Metriken zu Ablehnungen, Formatfehlern und Anbieterausfällen, um Sicherheitsprobleme von Betriebsproblemen unterscheiden zu können. Speichern Sie nicht automatisch vollständige Prompts, Dokumente und Antworten, wenn sie personenbezogene Daten, Geschäftsgeheimnisse oder regulierte Informationen enthalten. Legen Sie Aufbewahrungsdauer, Zugriff und Schwärzung sensibler Daten fest; sofern ausreichend, protokollieren Sie Hashes, IDs und strukturierte Ereignisse. Stellen Sie sicher, dass die Protokolle nicht zu einem neuen Weg werden, um Inhalte offenzulegen, die die Funktion schützen sollte.
Checkliste vor der Freischaltung der Funktion
- Werden Berechtigungen geprüft, bevor jedes Dokument abgerufen wird?
- Ist der übermittelte Kontext minimal und begrenzt und wird er als nicht vertrauenswürdige Eingabe behandelt?
- Werden Richtlinien und Geschäftsregeln außerhalb des Modells angewendet?
- Sind die Tools eingeschränkt und wird die Autorisierung bei jeder Operation erneut geprüft?
- Werden Antworten validiert, bevor sie angezeigt oder in Aktionen umgewandelt werden?
- Gibt es bei Entscheidungen mit erheblichen Auswirkungen eine menschliche Überprüfung oder Bestätigung?
- Gibt es wiederholbare adversariale Tests und Protokolle mit kontrollierter Aufbewahrung?
Wenn eine Antwort negativ ausfällt, begrenzen Sie den Umfang der Funktion oder belassen Sie Aktionen im Vorschlagsmodus, bis diese Lücke geschlossen ist. Der Schutz vor Prompt-Injection in Dokumenten hängt nicht davon ab, dass das Modell den Inhalt immer richtig interpretiert: Entscheidend ist, dass die Zugriffs- und Operationsgrenzen auch dann wirksam bleiben, wenn sich das Modell irrt.