Eine Suche kann schnell antworten und trotzdem falsche Ergebnisse liefern: Sie zeigt einen gelöschten Datensatz an, ignoriert eine kürzlich vorgenommene Änderung oder legt Inhalte offen, auf die der Nutzer nicht mehr zugreifen darf. Die Herausforderung besteht nicht nur darin, Text zu finden, sondern die Ergebnisse trotz Verzögerungen oder Fehlern mit den aktuellen Daten und Berechtigungen konsistent zu halten.
Um eine zuverlässige textbasierte Suche in PHP zu entwerfen, sollten Sie zunächst festlegen, wonach Nutzer suchen können müssen und welche Verzögerung akzeptabel ist. Anschließend entscheiden Sie, wo die Abfragen ausgeführt und wie abgeleitete Indizes aktuell gehalten werden. Die Datenbank muss die maßgebliche Datenquelle bleiben; der Suchindex ist eine wiederherstellbare Repräsentation und kein weiterer Ort, an dem Daten bearbeitet werden.
Beginnen Sie mit den Suchanforderungen
Beschreiben Sie die tatsächlichen Abfragen, bevor Sie eine Technologie auswählen. Wird nach Wörtern in Titeln und Beschreibungen, nach Wortgruppen, Präfixen oder mehreren Feldern gesucht? Gibt es Filter nach Status, Kategorie, Datum, Sprache oder Eigentümer? Sind Fehlertoleranz, Synonyme, Relevanz oder eine Sortierung nach Datum wichtig?
Legen Sie auch die Betriebsziele fest: akzeptable Latenz, Aktualisierungshäufigkeit, erwartetes Volumen und das Verhalten, wenn die Suche nicht verfügbar ist. „Aktuell“ kann bedeuten, dass eine Änderung sofort oder erst einige Sekunden später erscheint. Dieser Unterschied wirkt sich auf die Architektur aus und sollte ausdrücklich festgelegt werden.
Testen Sie die Qualität mit repräsentativen Abfragen. Berücksichtigen Sie häufige und seltene Begriffe, Datensätze mit leeren Feldern, Akzente, verschiedene Sprachen und Nutzer mit unterschiedlichen Berechtigungen. Prüfen Sie nicht nur, ob das erwartete Ergebnis erscheint, sondern auch, ob Reihenfolge und Filter sinnvoll sind.
Entscheiden Sie, ob SQL ausreicht
Eine SQL-Abfrage kann ausreichen, wenn der Datensatz und die Abfragen überschaubar sind, die Filter einfach bleiben und die Suchfunktionen der Datenbank den Anwendungsfall abdecken. Dabei spielen Datenbank-Engine und Konfiguration eine Rolle: Volltextfunktionen, Normalisierung und Relevanzbewertung sind nicht in allen Systemen identisch. Überprüfen Sie die Grenzen anhand realer Daten und Abfragen.
SQL bietet einen praktischen Vorteil: Daten und Suche können Teil desselben Konsistenzmodells sein. Außerdem muss zunächst kein zusätzlicher Dienst betrieben und kein separater Index synchronisiert werden. Das bedeutet nicht, dass jede Abfrage ohne Konzept mit Teilübereinstimmungen in Spalten suchen sollte. Prüfen Sie den Ausführungsplan, die verfügbaren Indizes und die Kosten der Filter.
Ein spezialisierter Index bietet sich an, wenn Abfragen Funktionen erfordern, die SQL nicht gut abdeckt, wenn Latenz oder Suchlast die primären Operationen beeinträchtigen oder wenn sich Relevanz, Facetten und Textanalyse unabhängig weiterentwickeln müssen. Das ist eine Architekturentscheidung und keine Pflicht, nur weil die Anwendung SaaS ist oder viele Datensätze hat.
Behalten Sie eine maßgebliche Datenquelle bei und definieren Sie den Index
Die transaktionale Datenbank sollte für Neuanlagen, Änderungen, Löschungen und Berechtigungen maßgeblich sein. Dokumentieren Sie, welche Entitäten und Felder indiziert werden, wie sie transformiert werden und über welche Kennung sich der ursprüngliche Datensatz finden lässt. Der Index kann normalisierten Text und für Filter vorgesehene Felder enthalten, darf aber ohne klaren Abgleichprozess nicht zu einer bearbeitbaren Kopie werden.
Bei Berechtigungen ist besondere Sorgfalt erforderlich. Entscheiden Sie, ob der Index Autorisierungsfelder speichert oder ob die Anwendung jedes Ergebnis anhand der maßgeblichen Datenquelle überprüft. Unabhängig vom Ansatz darf eine Suche keinen Zugriff gewähren, nur weil ein Dokument noch im Index vorhanden ist. Wenden Sie Zugriffskontrollen auf dem Server an und behandeln Sie Änderungen an Eigentümer, Sichtbarkeit oder Rolle als Änderungen, die ebenfalls übertragen werden müssen.
Wenn bei verzögerten Berechtigungsänderungen ein Höchstmaß an Sicherheit erforderlich ist, prüfen Sie die Autorisierung beim Abrufen der Ergebnisse erneut, auch wenn dadurch einige Ergebnisse verworfen werden. Die Strategie muss auch berücksichtigen, was bei einem Fehler dieser Prüfung geschieht: Ungeprüfte Ergebnisse sollten nicht als Ausweichlösung zurückgegeben werden.
Übertragen Sie Änderungen so, dass sie sich wiederherstellen lassen
Die Datenbank zu aktualisieren und anschließend in einer unabhängigen zweiten Operation eine Nachricht an eine Warteschlange zu senden, schafft ein Zeitfenster für Datenverlust: Die erste Operation kann bestätigt werden, während die zweite fehlschlägt. Ein gängiges Muster, um dies zu vermeiden, ist die transaktionale Outbox: Die Transaktion speichert die Geschäftsänderung und ein ausstehendes Ereignis in derselben Datenbank. Ein separater Prozess veröffentlicht oder verarbeitet diese Ereignisse und hält den Fortschritt fest.
Der Consumer aktualisiert den Index asynchron. Dadurch entsteht ein Zeitfenster, in dem der Index veraltet ist; dafür sollte ein konkretes Ziel festgelegt und die Verzögerung gemessen werden. Wenn der Anwendungsfall unmittelbar nach einem Schreibvorgang Lesezugriff erfordert, stellen Sie dafür eine Strategie bereit, etwa indem Sie den gerade gespeicherten Datensatz in der Antwort zurückgeben oder vorübergehend die maßgebliche Datenquelle abfragen. Versprechen Sie keine sofortige Konsistenz, wenn der Ablauf asynchron ist.
Gestalten Sie die Verarbeitung idempotent: Der zweimalige Empfang desselben Ereignisses darf weder Dokumente duplizieren noch Daten zurücksetzen. Verwenden Sie eine stabile Datensatzkennung und gegebenenfalls eine Version oder Änderungssequenz. Wenn Ereignisse in der falschen Reihenfolge eintreffen können, verhindern Sie, dass eine ältere Version eine neuere überschreibt. Wiederholungsversuche müssen sicher sein, und nicht verarbeitbare Nachrichten müssen für Untersuchungen sichtbar bleiben, statt stillschweigend zu verschwinden.
Behandeln Sie Löschungen und Neuaufbau als normale Fälle
Eine Löschung muss ausdrücklich übertragen werden. Wenn das System den Datensatz physisch löscht, bevor ein Worker ihn abfragen kann, muss das Ereignis die zum Löschen seines Dokuments erforderliche Identität enthalten. Bei verzögerten Abläufen oder Wiederholungsversuchen kann ein Löschmarker — ein Tombstone — oder eine Löschversion verhindern, dass ein älteres Ereignis das Ergebnis erneut anlegt.
Bei Schemaänderungen oder beschädigten Indizes sollten Sie den Index in begrenzten Stapeln aus der maßgeblichen Datenquelle neu aufbauen. Protokollieren Sie den Fortschritt, überwachen Sie Fehler und begrenzen Sie die Last auf der Datenbank. Während ein neuer Index befüllt wird, müssen Änderungen, die währenddessen auftreten, weiterhin übertragen werden. Andernfalls kann der Index bereits veraltet sein, bevor er aktiviert wird.
Sobald der neue Index vollständig und validiert ist, schalten Sie die Lesezugriffe kontrolliert um, beispielsweise über eine Konfiguration oder einen Alias, der mit der gewählten Technologie kompatibel ist. Halten Sie einen Rückweg offen, während Sie das Ergebnis überprüfen. Die schrittweise Aktivierung ist eine betriebliche Entscheidung; sie ist nicht gleichbedeutend damit, Produktänderungen ohne Kontrolle für Nutzer freizugeben.
Messen Sie die Konsistenz und bereiten Sie den Betrieb vor
Überwachen Sie die Verzögerung zwischen der Bestätigung einer Änderung und ihrer Verfügbarkeit in der Suche sowie ausstehende Ereignisse, Fehler, Wiederholungsversuche und dauerhafte Fehlschläge. Eine scheinbar aktive Warteschlange kann ein blockiertes Ereignis verbergen. Legen Sie anhand des Aktualitätsziels Schwellenwerte für Warnmeldungen fest und definieren Sie ein Verfahren, um Dokumente erneut zu verarbeiten oder zu reparieren.
Planen Sie einen Abgleich: Vergleichen Sie eine Stichprobe oder, sofern praktikabel, vollständige Datensätze der zu indizierenden Einträge mit den vorhandenen Dokumenten. So lassen sich verlorene Nachrichten, fehlerhafte Transformationen und nicht übertragene Löschungen erkennen. Auf eine Abweichung sollte eine dokumentierte Maßnahme folgen, etwa die erneute Indizierung eines Datensatzes oder der Neuaufbau des Index.
Checkliste vor dem Produktivbetrieb
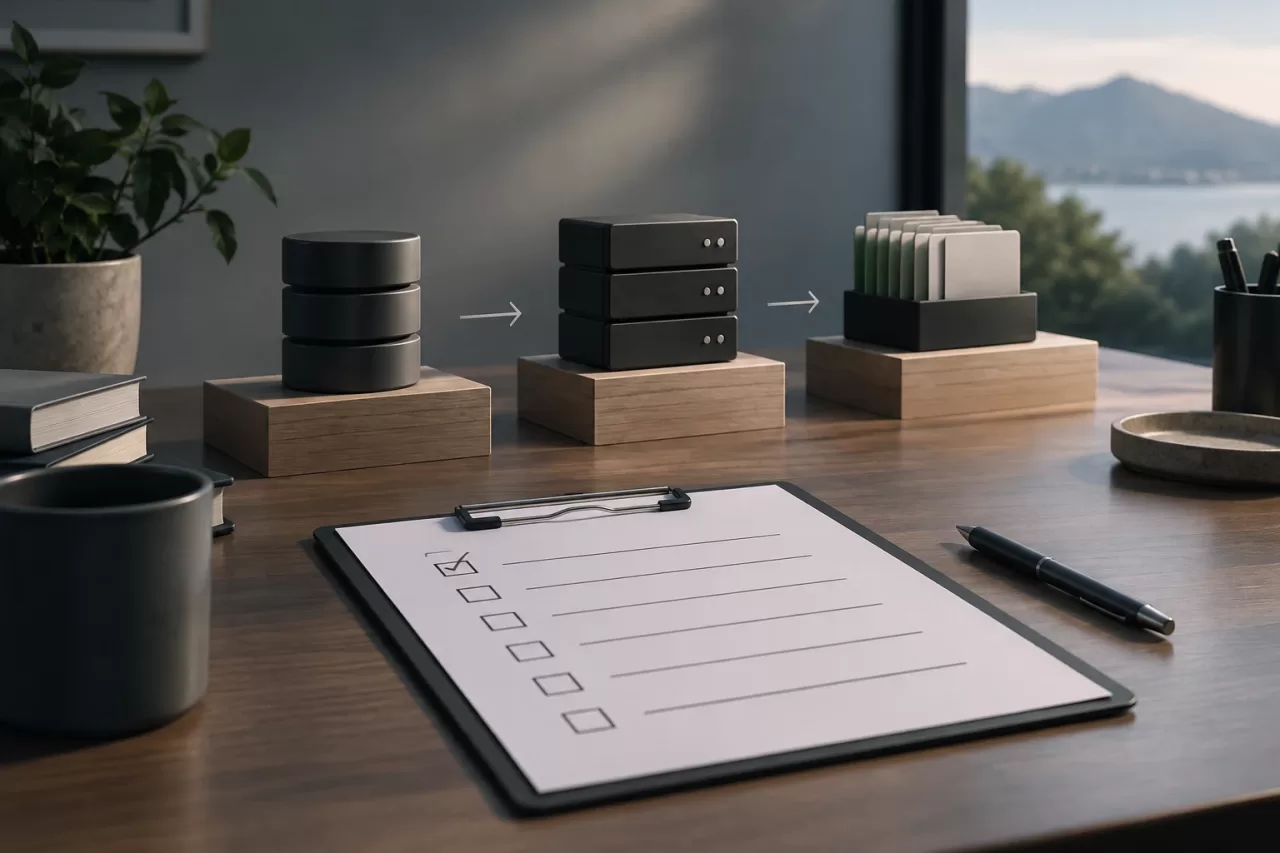
- Wurden die Abfragen und Relevanzkriterien anhand repräsentativer Fälle validiert?
- Sind die maßgebliche Datenquelle, die indizierten Felder und ihre Transformation dokumentiert?
- Erreichen Änderungen und Löschungen den Index auch nach einem Teilausfall?
- Verarbeitet das System wiederholte und ungeordnet eintreffende Nachrichten zuverlässig?
- Werden Berechtigungen bei der Suche angewendet und bei Änderungen aktualisiert?
- Wird die Verzögerung gemessen, und gibt es eine Routine für Abgleich und Neuaufbau?
- Gibt es einen Plan, um den neuen Index zu validieren und bei schlechteren Ergebnissen zurückzuwechseln?
Eine zuverlässige textbasierte Suche in PHP hängt weniger von der Wahl einer angesagten Technologie ab als von klar definierten Regeln für Konsistenz, Berechtigungen und Wiederherstellung. Beginnen Sie mit der einfachsten Lösung, die die gemessenen Anforderungen erfüllt. Reicht SQL für die benötigten Abfragen oder die erforderliche Leistung nicht mehr aus, führen Sie einen spezialisierten Index mit einer expliziten, beobachtbaren und wiederherstellbaren Synchronisierung ein.